一、总体策略与注释原则
Stereo-seq空间转录组(以下简称"空转")数据注释,推荐采用基于单细胞参考数据的解卷积注释策略:利用单细胞数据中已知的细胞类型表达谱,推断空转每个空间单元(bin /cellbin)的细胞类型组成,从而在空间维度上还原细胞类型分布。
注释遵循由粗到细、逐级细化的原则——先完成稳健的细胞大类注释,再针对特定大类向下细分至细胞亚型。
二、单细胞参考数据准备
2.1 数据来源与选择
优先使用自测单细胞数据:与空转样本同源、同组织类型的自测单细胞数据批次效应最小、生物学匹配度最高,是首选 reference。
次选公共单细胞数据集或文献公开的数据集:若无自测数据,可选用同类型组织的公共数据集(如同组织已发表的单细胞图谱)或文献公开的数据集。选用时需关注数据来源、测序平台、组织来源等,最大程度降低组织异质性带来的注释偏差。
常用公共单细胞数据集资源:
CELLxGENE(CZIScience):https://cellxgene.cziscience.com/
Broad Single-Cell Portal(SCP):https://singlecell.broadinstitute.org/single_cell
2.2 质量控制(QC)
单细胞reference的质量直接决定解卷积注释的可信度——reference是注释的"标尺",其细胞类型标签的准确性与类型覆盖完整度决定了空转注释的上限;标签错标或类型缺失会直接导致下游注释偏差。因此注释前必须对单细胞reference完成质控:
常规质控:细胞过滤(nFeature / nCount / 线粒体基因比例)、双胞(doublet)去除等标准流程。
注释准确性评估:通过marker gene dotplot(气泡图)检查各细胞类型标志基因的表达特异性,确认细胞类型标签与表达模式一致、无明显错标或串标。只有当 reference 的细胞类型标签经marker gene验证可靠后,方可用于下游解卷积。
import scanpy as sc
import scrublet as scr
import numpy as np

adata = sc.read_h5ad("ref.h5ad")

# 1. 常规质控:基因/细胞过滤 + 线粒体比例
adata.var['mt'] = adata.var_names.str.startswith('MT-')   # 小鼠改为 'mt-'
sc.pp.calculate_qc_metrics(adata, qc_vars=['mt'], inplace=True)
sc.pp.filter_cells(adata, min_genes=200)
sc.pp.filter_genes(adata, min_cells=3)
adata = adata[adata.obs.pct_counts_mt < 20, :].copy()

# 2. 去双胞:以下示例针对单样本reference
# 注:若reference包含多个样本,须按样本维度分别去双胞
rate = min(0.008 * adata.n_obs / 1000, 0.25)
sc.pp.scrublet(adata, expected_doublet_rate=rate, random_state=0)
n0 = adata.n_obs
adata = adata[~adata.obs['predicted_doublet'].astype(bool)].copy()
print(f"去 doublets: {n0} -> {adata.n_obs}")

# 3. 归一化与 log,供 marker dotplot 评估
sc.pp.normalize_total(adata, target_sum=1e4)
sc.pp.log1p(adata)
2.3 细胞类型层级整理
进入注释前需梳理reference的细胞类型层级,若reference已注释到细胞亚型层级,应先将各亚型合并至其所属的细胞大类,再进行大类解卷积注释。原因在于:大类间表达差异显著、可分性强,解卷积更稳健;而亚型间差异往往较小,在整张芯片层面直接做亚型解卷积易产生混淆。亚型细化留待大类注释完成后另行处理(见第四节)。
三、细胞大类注释
细胞大类注释的核心是选择合适的解卷积算法对空转数据进行大类解卷积,获得每个空间单元的细胞大类比例/归属。解卷积算法众多,不同方法对数据规模、稀疏度与组织类型的适配性不同。本节从工具获取与算法选型两方面说明。
3.1 工具获取
途径一 · SDAS整合工具:SDAS(Stereo Data Analysis Solution,空间转录组数据分析软件)是华大时空为Stereo-seq 时空组学数据开发的一款"开箱即用、解压即跑" 的Linux 命令行分析工具包,为用户提供从预处理至图表输出的全流程数据分析解决方案,其中内置的解卷积注释算法包括cell2location、RCTD、SPOTlight、Tangram,可在该软件中直接完成注释,无需单独部署各算法。
SDAS 工具包下载:
https://365.kdocs.cn/l/ck8Q456MSkbq
https://demo.stomicsdb.tech/STOmics_Software_Packages/SDAS/sdas-1.0.1.tar.gz
SDAS GitHub:
途径二 · 算法官网获取:上述各解卷积算法均有官方仓库,用户也可直接从软件官网下载,按官方文档独立部署使用。
3.2 算法选型
华大时空官网对比cell2location、RCTD、SPOTlight、Tangram、SCimilarity等方法在不同组织类型、不同分辨率的Stereo-seq数据上的准确性与资源消耗情况,可作为选型参考(建议结合样本数据规模、组织类型等特征选择合适工具):https://www.stomics.tech/STOmicsNews/2296.html
3.3 NA结果处理
在解卷积注释过程中,无论使用细胞大类还是细胞亚型进行注释,均会出现部分bin /cell注释结果为NA的现象,代表该单元无法匹配参考数据集内任何一种细胞类型。常见原因为对应单元质量较差、信号混杂。
若NA占比不高:建议直接舍弃该部分单元,不参与后续分析;
若NA比例很高:需重新排查原始空间数据质量、单细胞参考数据集适配性。
四、细胞亚型注释
亚型注释在大类注释完成的基础上进行,默认前一步的大类标签已经可靠,亚型细化只在各大类内部向下展开。核心原则:每个大类单独提取、单独做亚型细分——无论4.1还是4.2,都必须先把该大类的空间单元从整张芯片中提取出来,只在这个子集上、只用该大类的亚型marker做后续分析。
4.1 层次聚类打分
每个大类分别执行:先从空转数据中提取某一大类的所有空间单元,仅用该大类下各亚型的signature gene做打分与层次聚类,与其他大类完全隔离。流程为基因集打分 → 层次聚类 → 细簇判型 → 分配标签,具体实现见第七节参考代码。
基因集打分:对提取出的该大类空间单元的表达矩阵做标准化(log-normalize),用该大类各亚型的signature gene(亚型marker或单细胞reference中该大类内部的亚型DEGs)进行逐空间单元打分,得到亚型 × 空间单元的打分矩阵。
该步骤是将每个空间单元中整套亚型marker基因的整体表达水平量化为富集分数,以此作为判断该空间单元细胞亚型倾向的依据。
层次聚类与判型:基于打分矩阵对该大类空间单元做层次聚类,切分为大量细簇,每个细簇判给平均打分最高的亚型。
未分出亚型的处理:若某些细簇在所有候选亚型上打分都不显著、无法判定具体亚型,说明这些空间单元在亚型层面特征不明显,但仍属于该大类,应命名为大类名_Other(例如 B细胞下未分出亚型的簇命名为B_Other,T细胞下则为T_Other)。
结果校验:通过marker基因热图评估亚型注释效果;若亚型打分整体效果不佳,提示当前选用的亚型基因集特异性不足,尝试更换marker基因集重新分析。
参考文献:Tang Z, et.al. Spatial transcriptomics reveals tryptophan metabolism restricting maturation of intratumoral tertiary lymphoid structures.Cancer Cell, 2025; 43, 1025-1044.e14
4.2 亚型解卷积
每个大类分别执行解卷积,空转与单细胞reference都需要先按大类拆分,再在大类内部做亚型解卷积。
单细胞reference先做亚型注释:从单细胞reference中提取该大类对应的所有细胞,在这个大类子集内部先完成亚型注释——按常规单细胞流程(子集重新聚类,根据各亚型的marker gene 判型)标注该大类的各个亚型。
空转数据提取该大类空间单元:从空转数据中提取所有注释为该大类的空间单元,仅在这个子集上做解卷积。
在该大类内部单独做亚型解卷积:以第一步生成的有亚型标签的该大类单细胞子集为reference,对该大类的空转数据做解卷积注释(算法同第三节)。每个大类分别提取做解卷积——按大类拆开可缩小候选类型范围、降低类型间混淆,更利于识别亚型。
NA 结果的处理:解卷积后如果出现部分空间单元结果为 NA,代表该空间单元在亚型层面无法匹配。这些单元仍属于该大类,同样命名为大类名_Other(如 B_Other、T_Other),以保留其大类归属。
五、注释结果评估
注释完成后,可从多维度交叉验证结果可靠性:
Marker gene表达热图:各细胞类型标志基因是否在对应细胞类型呈现特异性富集,推荐用平均表达量做z-score标准化后绘图,消除基因绝对表达丰度差异,方便横向对比
解卷积分数热图:评估"主导标签"与"解卷积分数"是否吻合:注释准确时高值集中在对角线(代码见七.2)
细胞类型比例合理性:推断的各细胞类型比例与单细胞reference、已知组织组成是否在合理范围,避免某类异常偏高 / 偏低
与单细胞 reference 的一致性:空转注释的细胞类型组成与表达特征是否与单细胞reference吻合(代码见七.3)
形态学(H&E)对照:将注释区域与组织学形态结构对照,确认与解剖学结构(如皮层、腺体、基质区)一致
当注释效果不理想时,建议回溯排查前面的流程,例如单细胞参考数据集质量、算法选型、参数设置、bin 粒度选择等,逐项定位后迭代。
六、特殊场景处理:拼片/TMA样本
对拼片样本或组织微阵列(TMA)样本,若整张芯片统一注释效果不理想(多见于样本间批次效应、组织异质性较强),建议按单个样本分别独立注释,再合并结果。分样本注释可减少样本间相互干扰,提升单样本注释准确度。
对拼片或TMA样本进行分割,优先推荐使用SAW count 或SAW realign(版本 >= 8.3.0)并添加--split-tissue-into-labels参数。若数据由旧版SAW(< 8.3.0)生成且不便重跑,也可使用Python脚本基于已输出的tissue mask进行手动分割提取。
6.1 基于SAW分割(推荐)
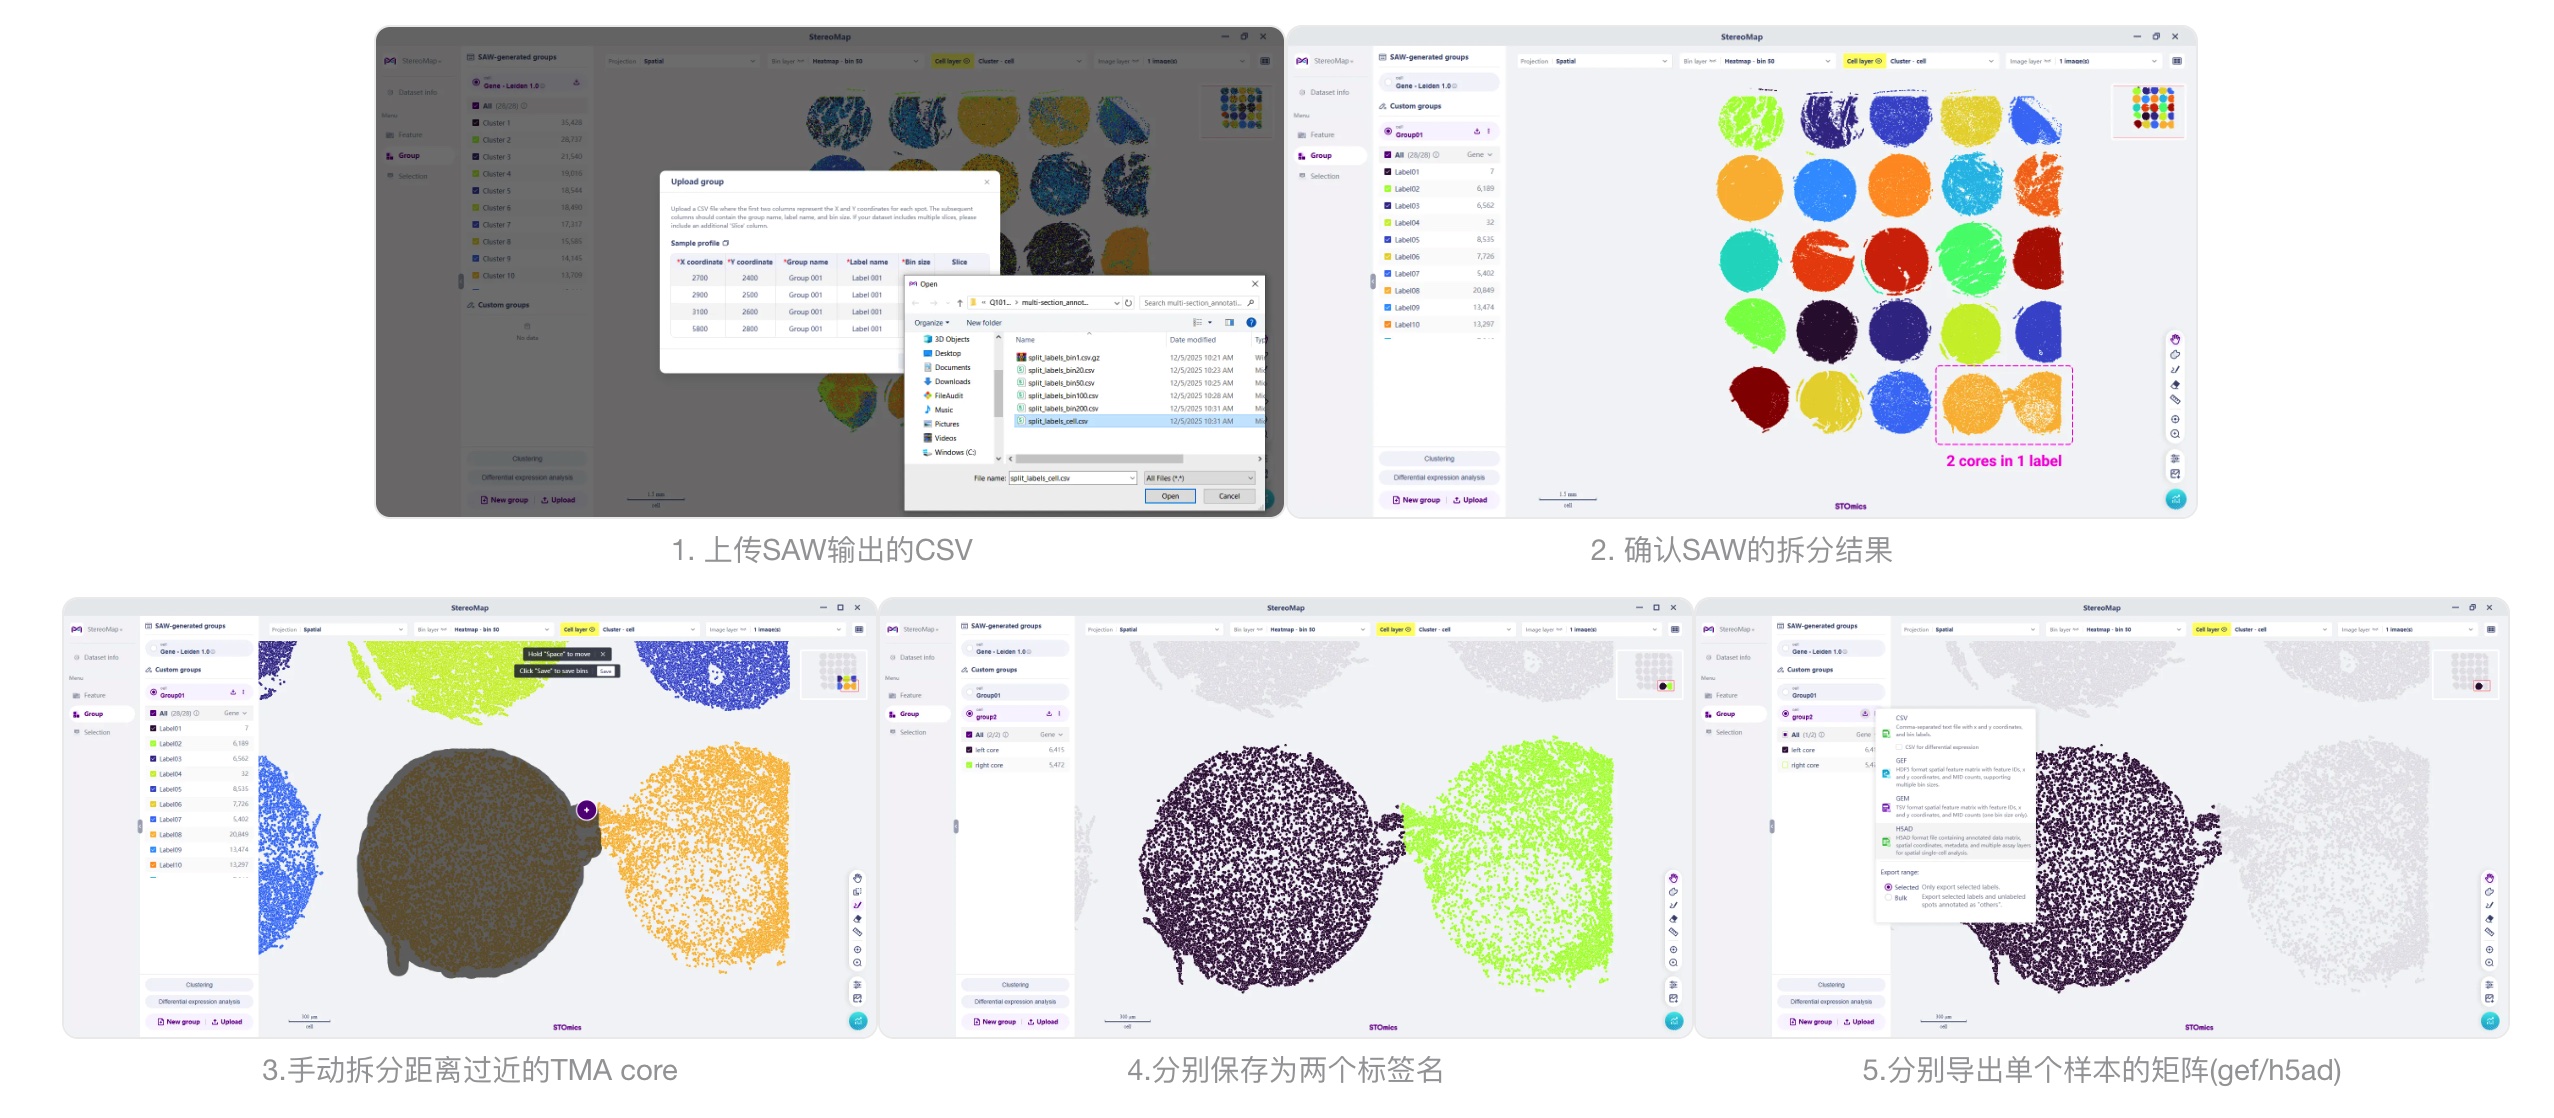
该方法使用SAW count 或SAW realign(版本 >= 8.3.0)并添加--split-tissue-into-labels 参数。该方法可直接基于图像自动将各组织块识别为独立的子标签区域,并支持导入StereoMap(版本 >= 4.3.0)中可视化查看和手动调整标签区域,确认无误后进一步导出拆分后的gef/h5ad用于后续分析。
SAW 8.3.0说明文档:https://www.stomics.tech/service/new-saw-operation-manual.html
StereoMap 4.3.0说明文档:https://www.stomics.tech/service/new-StereoMap.html
6.2 基于tissue mask手动分割
该方法基于SAW已输出的tissue mask用Python脚本进行分割:传入要分割的h5ad文件与tissue mask文件,返回得到带 obs['mask_label'] 标记的h5ad文件,参考代码如下:
import scanpy as sc
import cv2
# tissue mask:result/sample/outs/image/sample_ssDNA_tissue_cut.tif

def split_tma(h5ad_file, tissuemask):
    adata = sc.read(h5ad_file)
    adata.X = adata.raw.X    # 根据实际情况选择,是否要把X换成原始表达矩阵
    mask = cv2.imread(tissuemask, cv2.IMREAD_GRAYSCALE)
    num_labels, labels = cv2.connectedComponents(mask)
    label_list = []
    for i in adata.obs.iterrows():
        cx = i[1]['x']
        cy = i[1]['y']
        this_label = labels[cy, cx]
        label_list.append(this_label)
    adata.obs['mask_label'] = np.array(label_list).astype(str)
    return adata

adata=split_tma("sample.h5ad","outs/image/sample_ssDNA_tissue_cut.tif")
# 查看标签的空间分布
sc.pl.spatial(adata, color='mask_label', spot_size=20, show=False,legend_loc="on data")
七、参考代码
细胞亚型层次聚类代码
http://cdn-newfile.stomics.tech/software-packages/celltype_annotation/anno_score_heatmap.ipynb
解卷积分数热图代码
http://cdn-newfile.stomics.tech/software-packages/celltype_annotation/hier_clustering_subtype.ipynb
与reference细胞类型一致性分析代码
http://cdn-newfile.stomics.tech/software-packages/celltype_annotation/metaneighbor_correlation.ipynb