HTML 报告
概览
saw count/realign 分析流程运行结束后,会输出一个交互式的 HTML 报告文件 <SN>.report.html,报告的具体内容会因使用的分析流程和输入参数而异,但都遵循整体统一的格式框架。
本页面部分展示了以下样本的报告结果:
- Stereo-seq T FF V1.3 的小鼠脑样本
- Stereo-seq N FFPE V1.0 的小鼠肺组织样本
- Stereo-CITE T FF V1.0 的小鼠胸腺组织样本
SAW 8.2 开始,HTML 报告经历了重大 UI 升级,内容布局、信息层级和功能模块得到了全面优化。报告首次以多组学和多模态的视角呈现,通过顶部的全局导航栏(Gene、Protein、Microbe、Image)将数据信息进行了高效的分类与整合。
基因
Summary
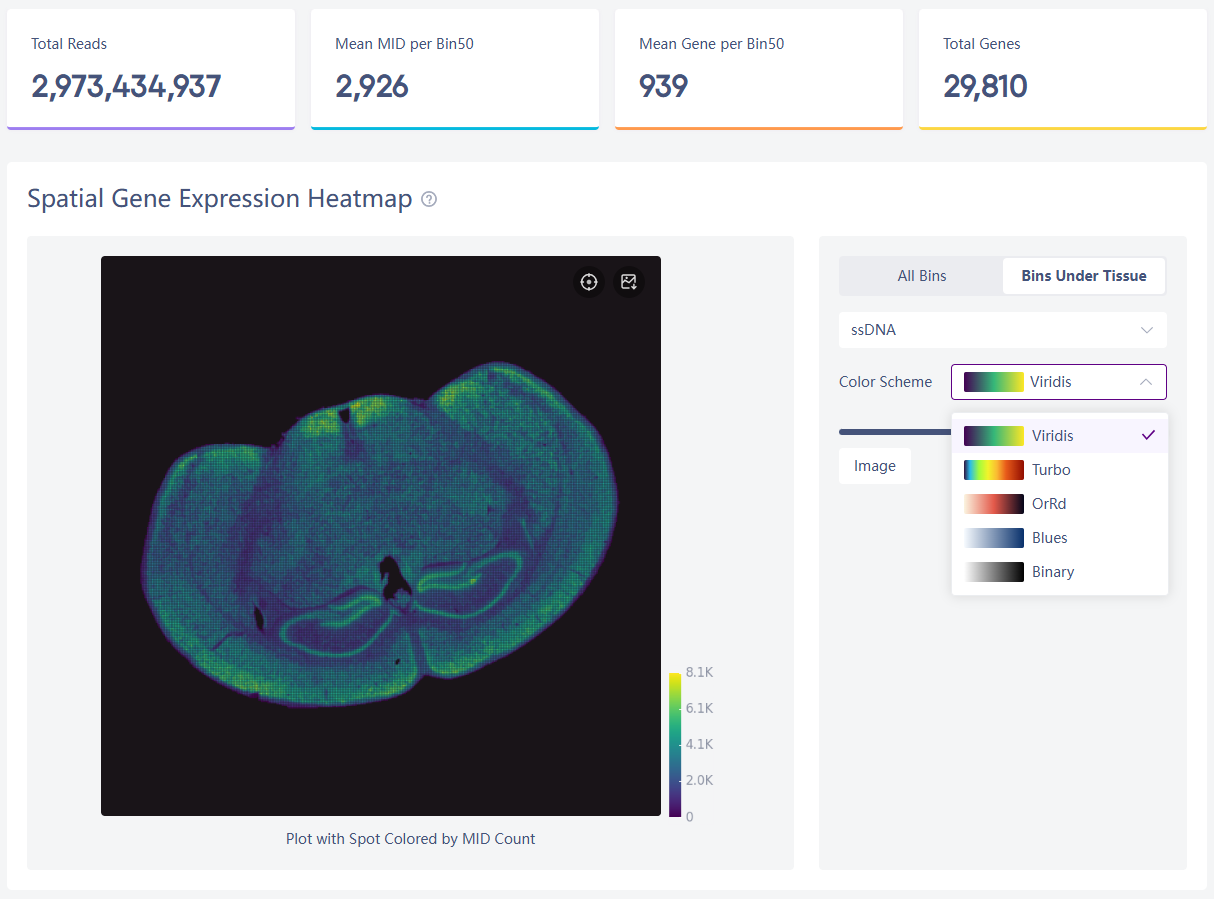
Expression heatmap and four key metrics
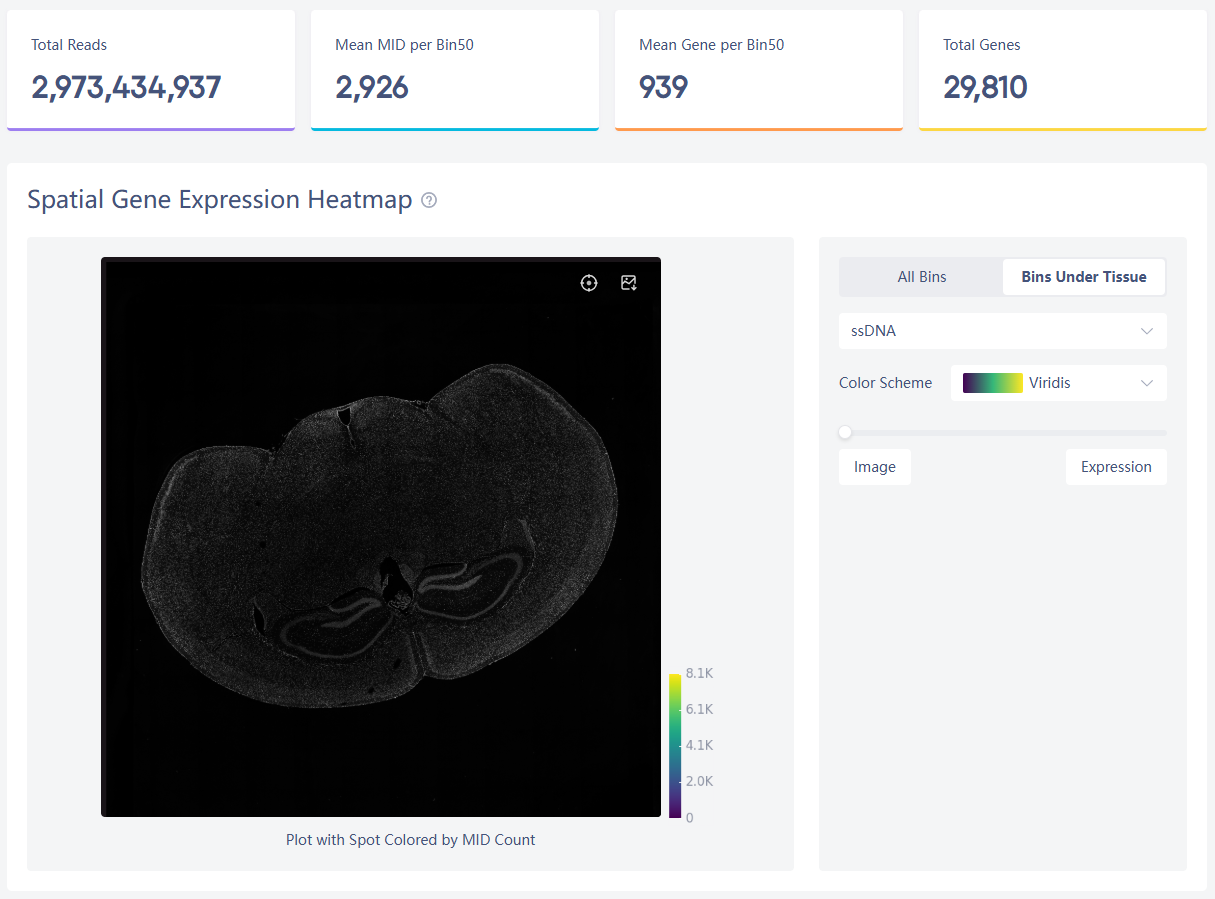
Microscope image and four key metrics
左侧的空间基因表达分布图展示了所有 bin 以及组织覆盖区域下的 bin,显示了在 bin50 分辨率下的 MID 计数。
- Total Reads:输入 FASTQ 文件的总测序 reads 数
- Mean MID per Bin50:组织区域下bin50 的平均 MID 数
- Mean Gene per Bin50:组织区域下bin50 的平均基因数
- Total Genes:所有 bin 中检测到的总基因种类数
Gene key metrics
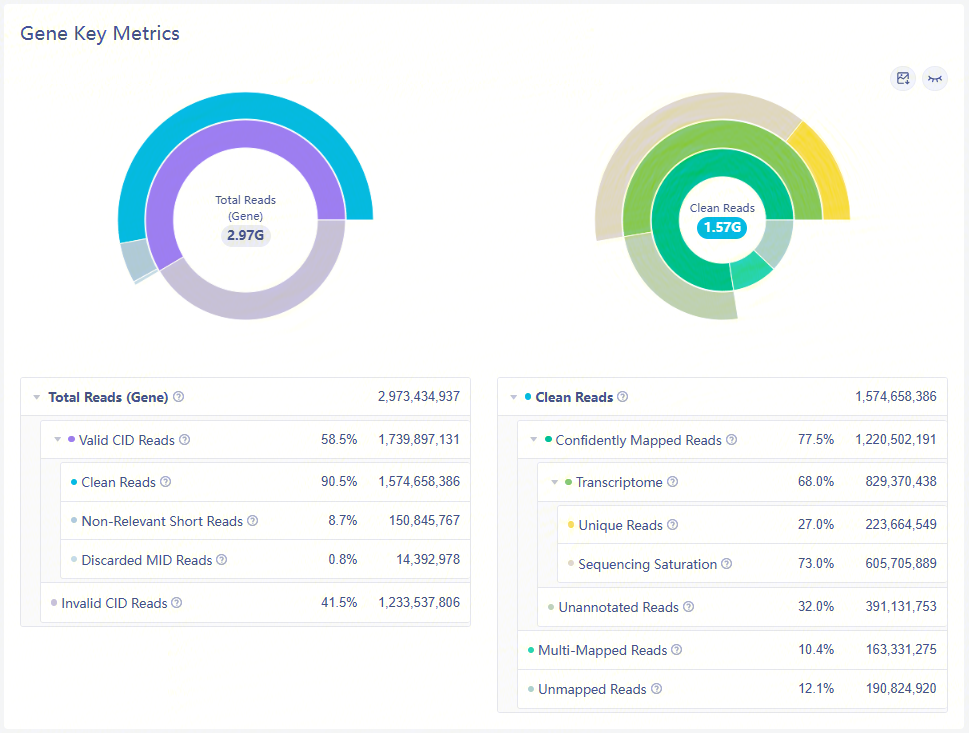
Details and sunburst plot of key metrics
基因组数据的核心指标信息如下:
| Metric | Description |
|---|---|
| Total Reads (Gene) | 转录组测序的总 reads 数 |
| Valid CID Reads | CID(坐标 ID)序列与 Stereo-seq 芯片 Mask 成功匹配的 reads 数 |
| Invalid CID Reads | CID 序列无法与 Stereo-seq 芯片匹配的 reads 数 |
| Clean Reads | 成功通过所有过滤步骤的 reads 数 |
| Non-Relevant Short Reads | 非相关的短 reads 数(例如:包含了芯片 DNB 特定序列,或在去除接头和 polyA 尾后长度小于 30bp 的 Reads)。 |
| Discarded MID Reads | 包含无效 MID 的 reads 数,即 MID 序列包含 N 碱基或具有 1 个以上低质量碱基(Q-score < 30) |
| Confidently Mapped Reads | 高置信度且比对到基因组单一区域的 reads 数(通常包括唯一比对的 reads ,以及多重比对中得分最高的 reads ) 取决于 |
| Transcriptome | 可比对到单一基因转录本的 reads 数 |
| Unique Reads | 具有唯一基因 ID、CID(坐标 ID)和 MID(分子 ID)且经过注释的 reads 数(即去除了 PCR 重复) |
| Sequencing Saturation | 包含重复 MID 且经过 MAPQ 校正的注释 reads 数(测序饱和度) |
| Unannotated Reads | 无法比对到任何基因或单一基因转录本的 reads 数 |
| Multi-Mapped Reads | 以同等高置信度比对到基因组多个位置的 reads 数(排除了最佳匹配项) 取决于 |
| Unmapped Reads | 无法比对到参考基因组的 reads 数 |
| rRNA Reads | 根据输入的参考基因组,比对到特定 rRNA 区域的 reads 数 |
Annotation
基于 GTF/GFF 文件注释的 reads 指标:
| Metric | Description |
|---|---|
| Exonic | 高置信度且比对到外显子区域且在基因同一条链上的 reads 数 |
| Intronic | 比对到转录组但在注释基因反义链上的 reads 数 |
| Intergenic | 比对到基因间区且在基因同一条链上的 reads 数 |
| Antisense | 高置信度且比对到内含子区域且在基因同一条链上的 reads 数 |
Tissue region
组织区域下信息统计:
| Metric | Description |
|---|---|
| Tissue Area | 检测到的组织面积(单位:mm²) |
| MID Under Tissue | 组织覆盖区域下的 MID 计数,检测到的组织区域取决于自动/手动组织分割的结果 |
| Fraction MID in Spots Under Tissue | 组织区域下的 MID 占总 Unique Reads 的比例(组织区域下 MID 数 / Unique Reads) |
Sequencing saturation
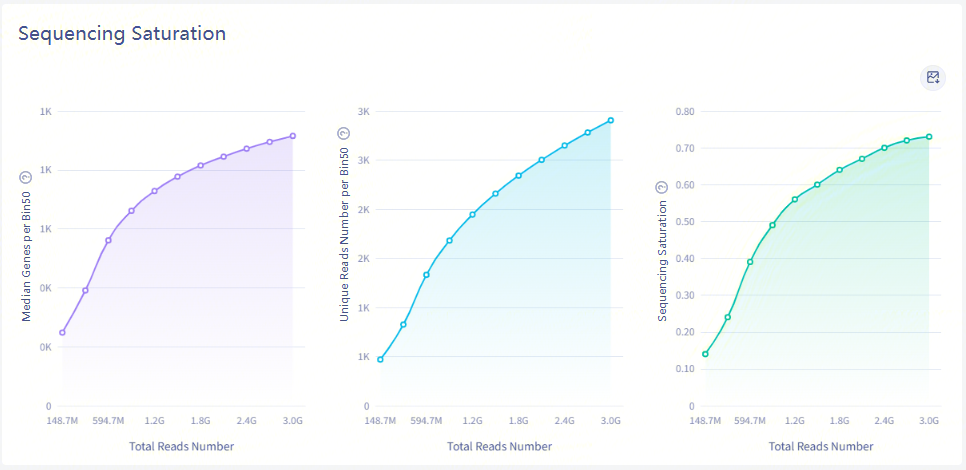
Sequencing saturation curves
HTML 报告中的饱和度分析可评估测序数据的整体质量。为提高计算效率,程序会在 bin20 或 bin50 维度成功注释的 reads 中进行随机下采样。因此,同一数据的多次运行结果可能会有微小差异,曲线的总体形状保持一致
- 图 1:随着随机采样数量的增加,bin50 中的基因中位数逐渐增加。
- 图 2:基于随机采样样本的 Unique Reads 数据拟合的曲线。
- 图 3:样本 Unique Reads(具有唯一 CID、基因名和 MID 的 Reads)的统计。饱和度值 =
1 - (Unique Reads) / (Total Annotated Reads)。随着采样量增加,拟合曲线变得几乎平坦,表明数据趋于饱和。
- 是否需要加测取决于整体项目设计和样本情况。通常建议对珍贵样本进行加测,报告中 0.8 的阈值仅作为建议指导的参考提醒。
- 三张图的 X 轴相同,Y 轴分为饱和度值、基因中位数和 Unique Reads 数。
Sample information
展示输入数据集的基本信息:
| Metric | Description |
|---|---|
| Sample ID | HTML 报告的 ID |
| Organism | 样本物种信息 |
| Tissue | 样本组织信息 |
| Reference | 用于 reads 比对和注释的参考基因组 |
| Kit Version | Stereo-seq 试剂盒版本 |
| Sequencing Type | Stereo-seq 试剂盒测序方案 |
| Stereo-seq Chip SN | 芯片序列号 |
| FASTQ | 输入的 FASTQ 文件详情 |
Square Bin
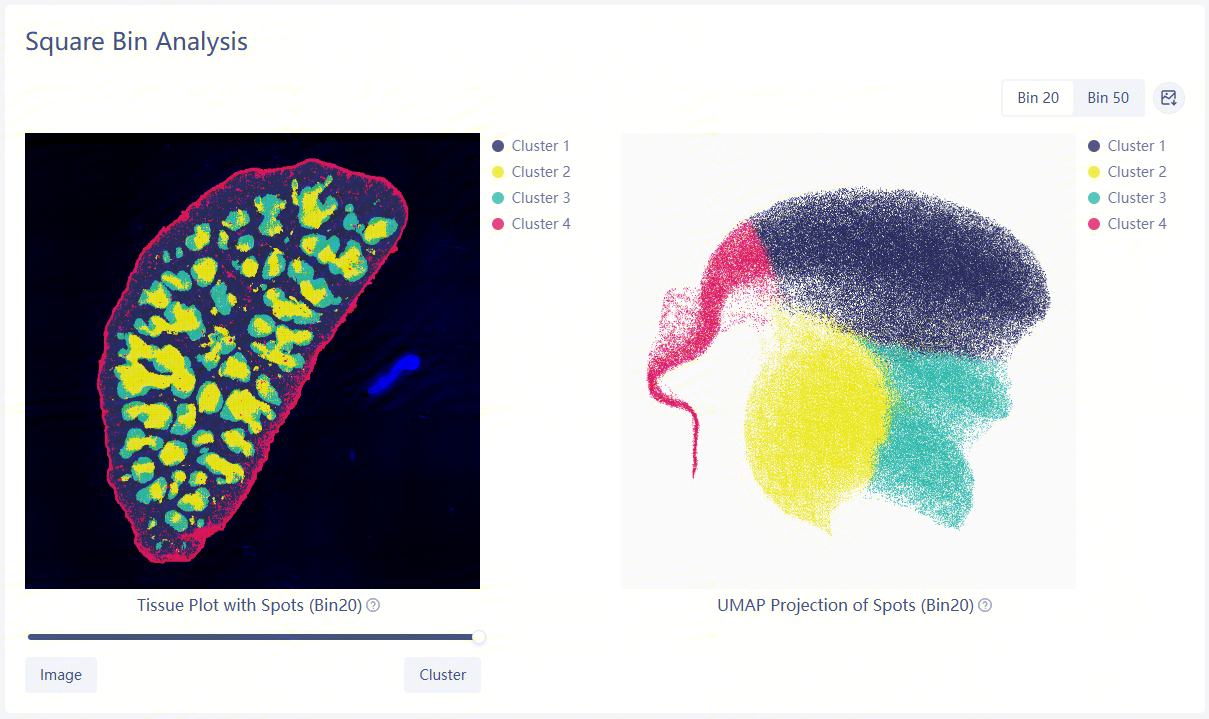
此页面包含基于 <SN>.tissue.gef 文件在主要 bin 维度的统计、图表、聚类、UMAP 和差异表达分析结果。默认展示 bin20 和 bin50 的分析结果(取决于启动分析时设置的 --custom-bin-size)
Statistics
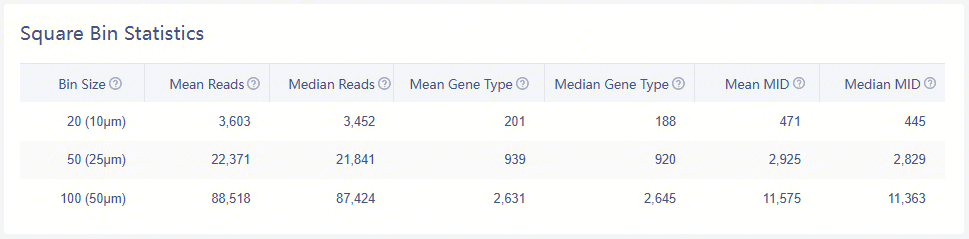
Statistics of bins under tissue-coverage region
组织覆盖区域内的 bin 维度统计 :
| Item | Description |
|---|---|
| Bin Size | 一个单位聚合 bin(表达单位 spot),用于在方形区域内聚合芯片上的 DNB(例如,bin20 = 20 x 20 DNBs) |
| Mean Reads (per bin) | 组织区域内 binN 的 reads 测序平均数 |
| Median Reads (per bin) | 组织区域内 binN 的 reads 测序中位数 |
| Mean Gene Type (per bin) | 组织区域内 binN 的平均基因数 |
| Median Gene Type (per bin) | 组织区域内 binN 的基因中位数 |
| Mean MID (per bin) | 组织区域内 binN 的 MID 平均数 |
| Median MID (per bin) | 组织区域内 binN 的 MID 中位数 |
Plots
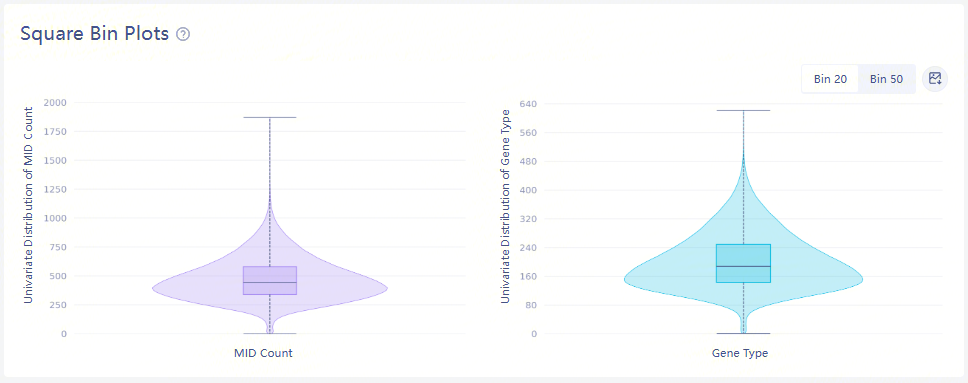
Distribution plots of MID and gene type
小提琴图展示了每个 bin 中去重后的 MID 计数和基因种类的分布。
Clustering & UMAP
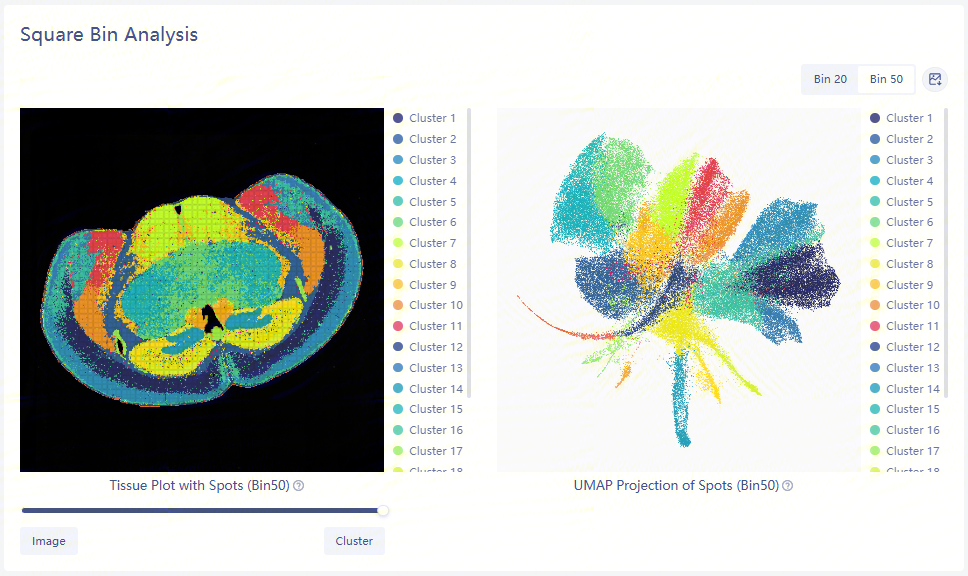
Leiden clustering and UMAP projection
基于 Leiden 算法进行聚类,并根据聚类结果进行 UMAP 投影着色,分析都是基于 SN.tissue.gef 矩阵进行的计算,距离更近且基因表达谱相似的 spot 会被分配相同的颜色。
聚类分析是基于 SN.tissue.gef 矩阵,使用 Leiden 算法计算得出的。UMAP 的降维投影是基于 SN.tissue.gef 进行的,并通过聚类分群结果进行着色,即距离较近且具有相似基因表达谱的 spot 会被分配相同的颜色。
对于超大尺寸的 Stereo-seq 芯片,报告会通过下采样 (downsampling) 来展示结果,以减小文件体积、尽量减少 spot 重叠以确保平滑显示。
当图表中的 spot 数量超过一百万时,会严重影响视觉渲染质量和文件读取性能,因此软件引入了下采样机制。Bin size 越小,需要映射的 Spot 就越多。关于下采样的比例和步长详情,请参阅报告模块的日志。如果希望进行深度的可视化和下游分析,推荐使用 StereoMap 软件。
Differential expression analysis
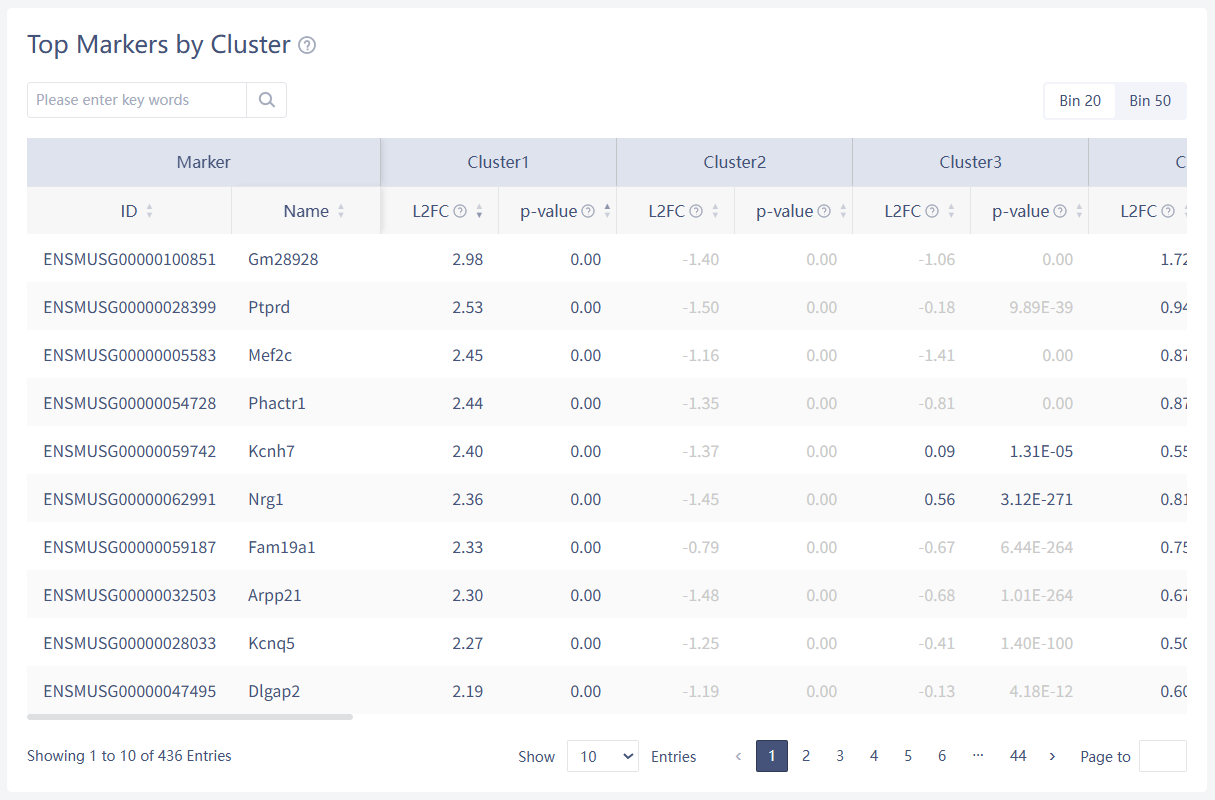
Marker feature table
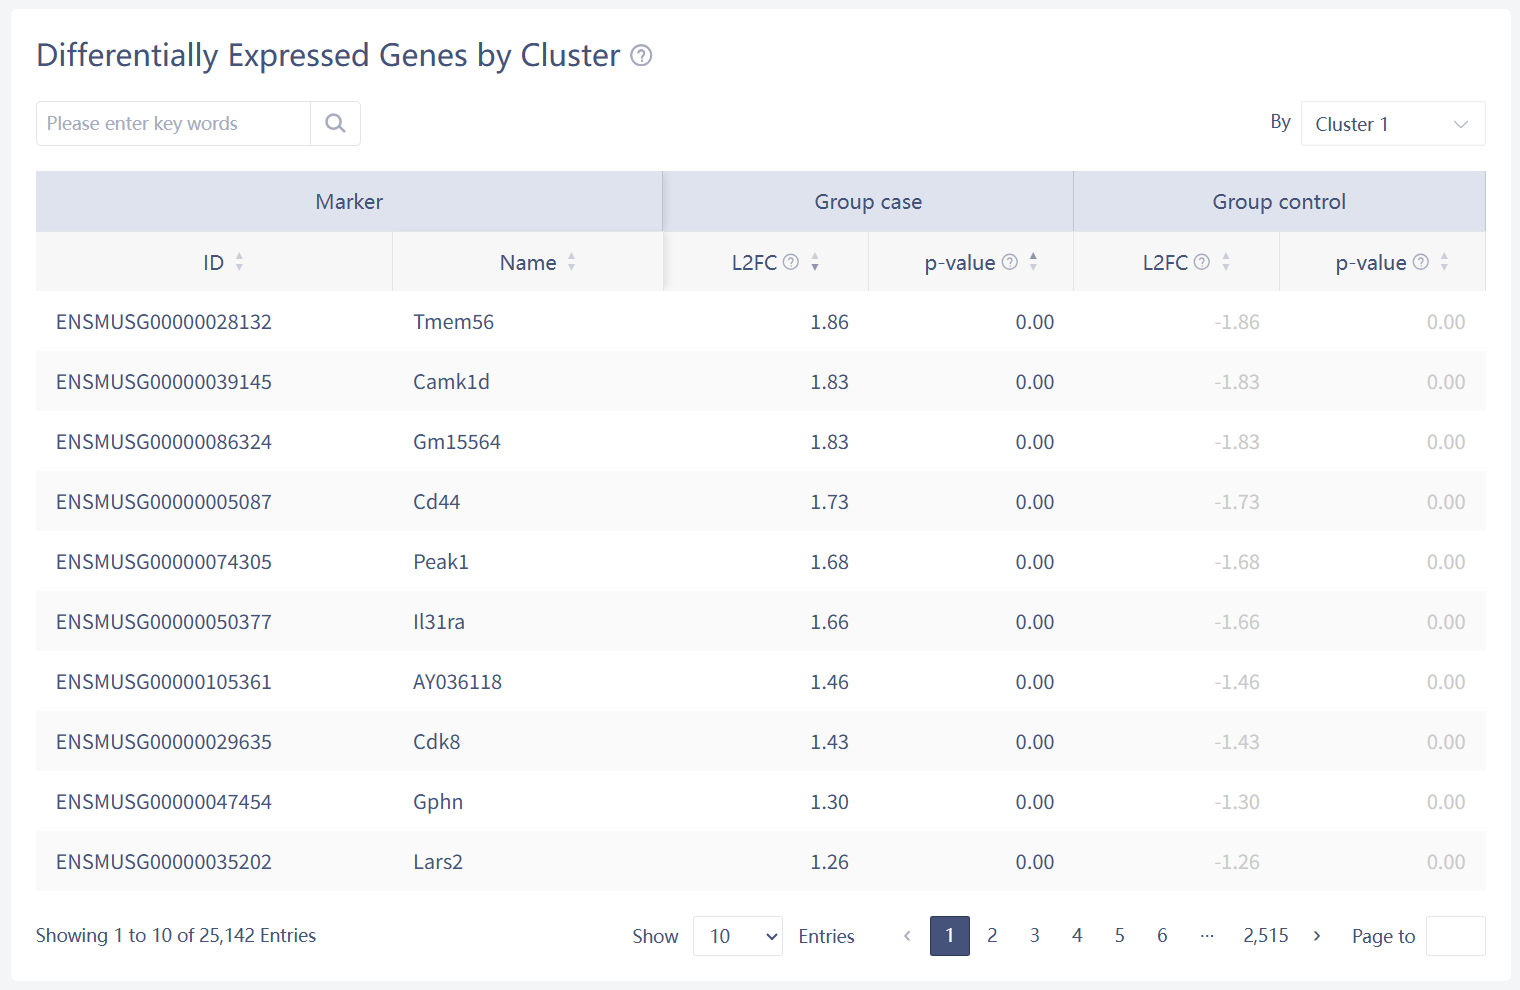
差异表达分析的目的是识别在某个特定的聚类簇(cluster)中相比于样本其余区域表达量显著更高的标记物(marker 基因)。对于每个标记物,程序都会在该聚类簇与其余所有样本区域之间进行差异表达统计检验。
- Log2差异倍数 (Log2 fold-change, L2FC):对特定聚类簇与其他坐标区域之间基因表达比例的对数(以 2 为底)估算值。L2FC 值为
1.0代表该相关聚类簇内的基因表达量实际增加了 2 倍。 - p值 (p-value):基于负二项分布检验(Negative binomial test),p 值用于指示这种表达量差异的统计学显著性。
- 矫正p值 (Adjusted p-value):为了降低假阳性率,系统采用了 Benjamini-Hochberg 方法对多重假设检验的 p 值进行了校正。
此外,该表保留每个聚类簇中按照 L2FC 降序排列的前 N 个核心特征。表格中置灰的特征代表其矫正后的 p 值 >= 0.10 或 L2FC < 0(即在当前簇中不具备显著的上调特征)。
- N 的取值范围为 1 到 50,代表每个聚类簇显示的最显著特征数量。设置该值是为了将表格的总展示条目严格限制在 10,000 条以内。其具体计算公式为:,其中 为当前样本划分出的聚类簇总数。
- 可以点击表格的任意列标题进行排序,或利用搜索框直接检索感兴趣的目标基因。
当 marker 特征表中的 L2FC 值为空、"infinity" 和 "-infinity" 时,分析结果是正常的。这些情况在下文有详尽的解释。
L2FC 的计算与特定基因在实验组和对照组细胞中的表达数量有关。由于 L2FC 的计算以自然对数为底,当表达关系具有极高或极低值时,就会出现这三个特殊值:空、"inf" 和 "-inf"。下方的截图使用了 inf 和一个常数来进行简单的演示。
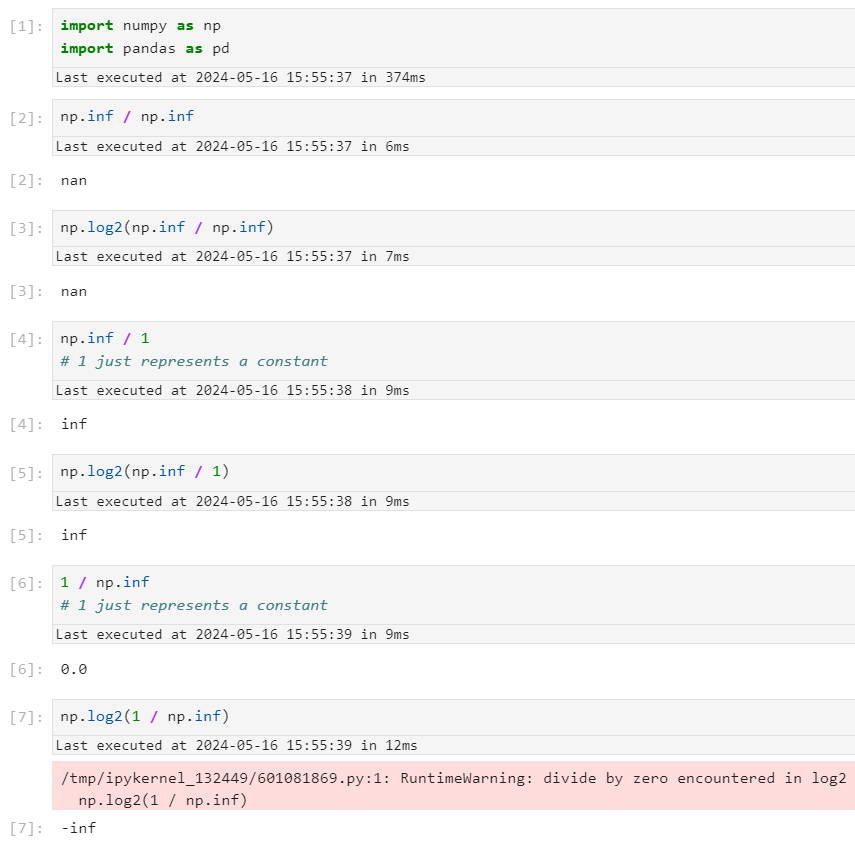
An example in Notebook using Python
p-value 应随着列表的下降而增加(最大值为 1),无限接近于 0。\ 如果发现在结果表中 p-value 为 0,是因为计算出的差异表达特征极其显著,导致 p-value 极小,使得其超过数据类型的限制(通常为 float64,取决于基础计算包),导致出现无法用科学计数法表示的情况。
Cell Bin
此页面包含在 cellbin 维度的统计、图表、聚类、UMAP 和差异表达分析的结果。细胞边界外扩在 saw count/realign 期间是自动执行的,这意味着 "Cell Bin" 页面下的内容是基于 SN.adjusted.cellbin.gef 统计和分析得出的。
当设置 --adjusted-distance=0 时,此选项卡的所有内容都是基于未核外扩的 SN.cellbin.gef 。
Statistics
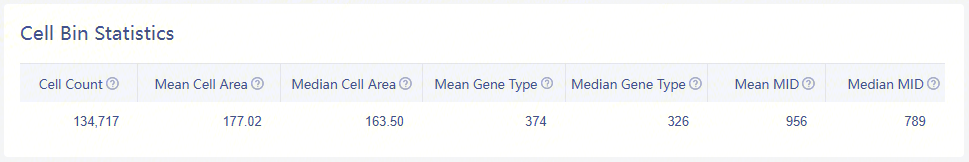
Detailed statistics of cellbin
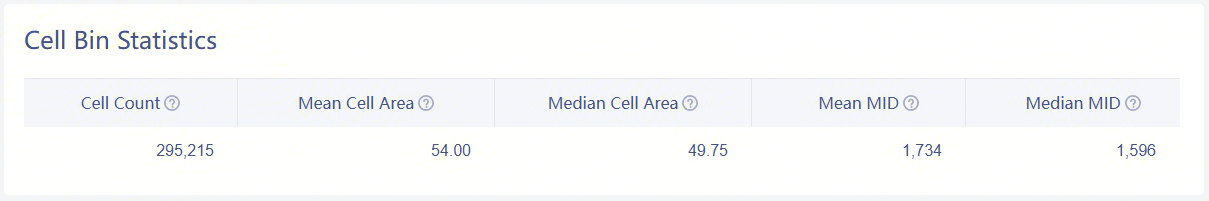
Cellbin维度的统计信息:
| Item | Description |
|---|---|
| Cell Count | 检测到的细胞总数(MID 计数 >= 1) |
| Mean Cell Area | 细胞面积平均值(单位:μm²) |
| Median Cell Area | 细胞面积中位数(单位:μm²) |
| Mean Gene Type | 每个细胞的基因平均数 |
| Median Gene Type | 每个细胞的基因中位数 |
| Mean MID | 每个细胞的 MID 平均计数 |
| Median MID | 每个细胞的 MID 中位计数 |
Plots
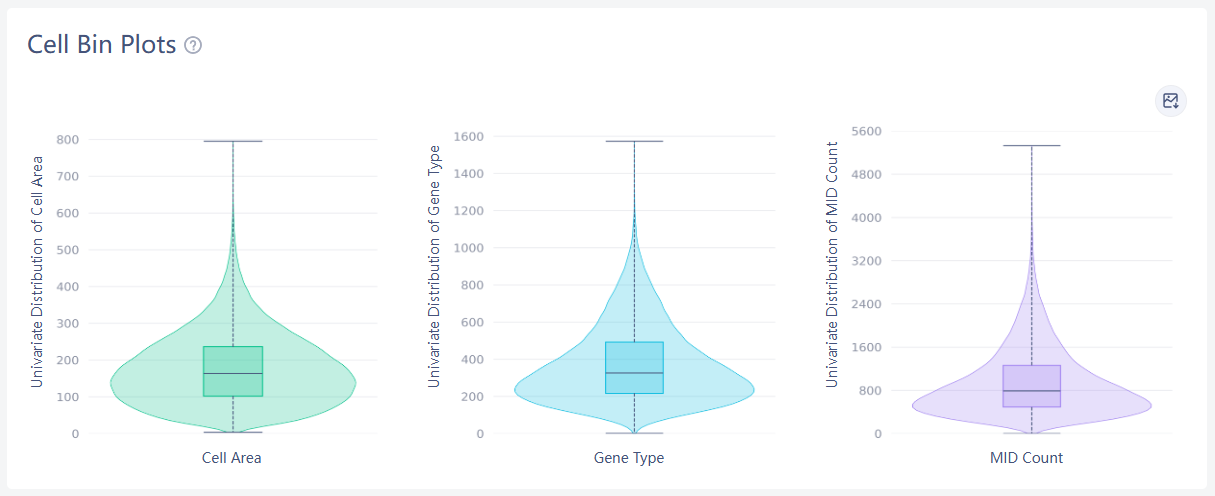
Distribution plots of MID, gene type and cell area
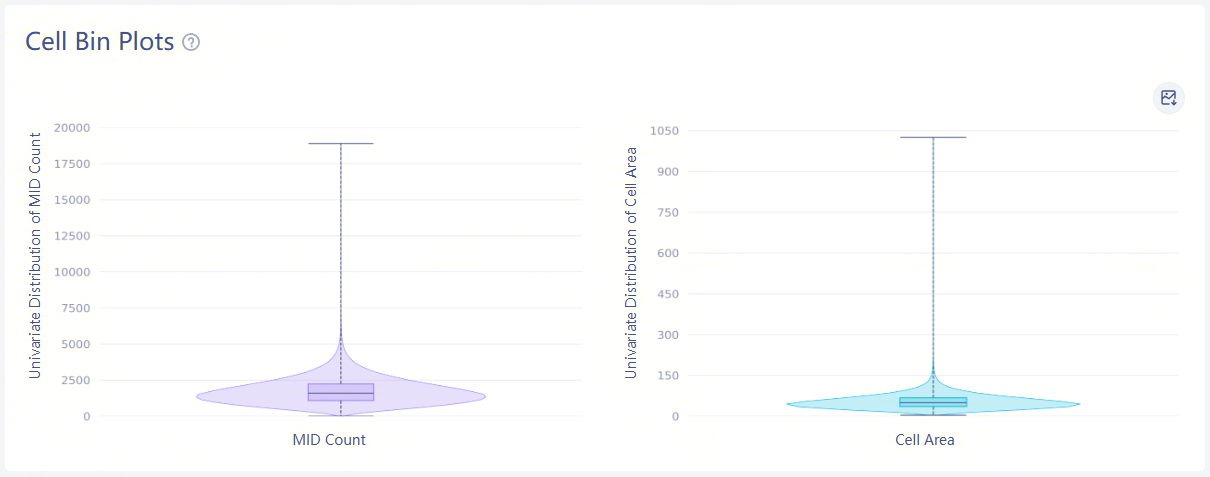
小提琴图显示了 cellbin 中去重后的 MID 计数、基因类和细胞面积的分布。
Clustering & UMAP
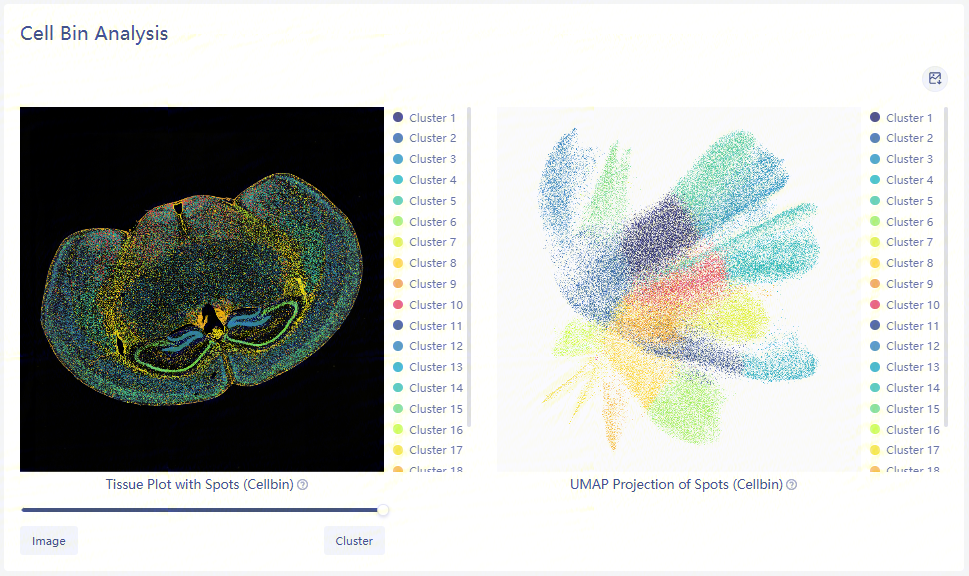
Leiden clustering and UMAP projection
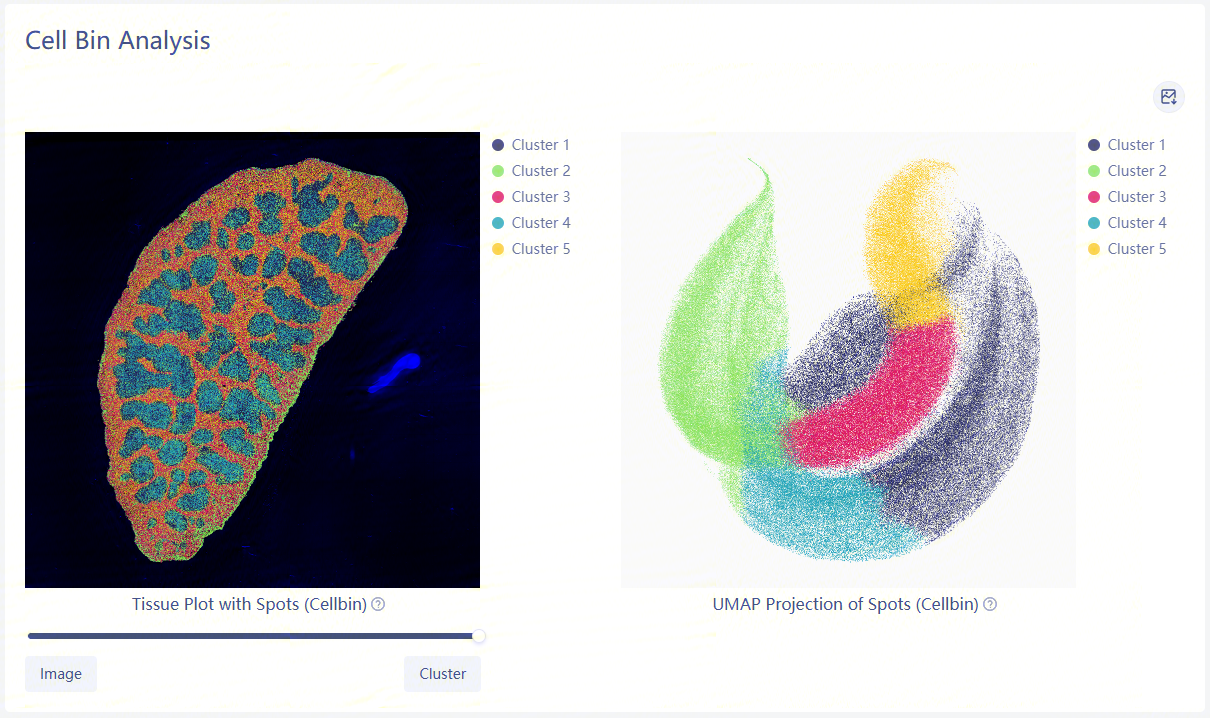
聚类分析是基于 SN.adjusted.cellbin.gef 或 SN.cellbin.gef,使用 Leiden 算法计算得到的。UMAP 降维投影是基于 SN.adjusted.cellbin.gef 或 SN.cellbin.gef 进行的,并通过自动聚类进行着色。距离较近且具有相似基因表达谱的 spot 会被分配相同的颜色。
请注意,对于某些超大尺寸的 Stereo-seq 芯片,软件将通过下采样的方式呈现结果,以减小文件体积、最小化 spot 重叠,并确保平滑的显示,尤其是在有过多 spot 需要可视化的情况下。
我们发现,当图中的 spot 数量超过一百万时,会严重影响视觉映射质量和文件读取性能。因此,实施了下采样。更小的 bin 尺寸需要更大量的 spot 来进行有效的映射。关于下采样比例和步长的详细信息,请参阅报告模块的日志。如果希望进行深度的特定数据可视化和下游分析,StereoMap 是更好的选择。
Differential expression analysis
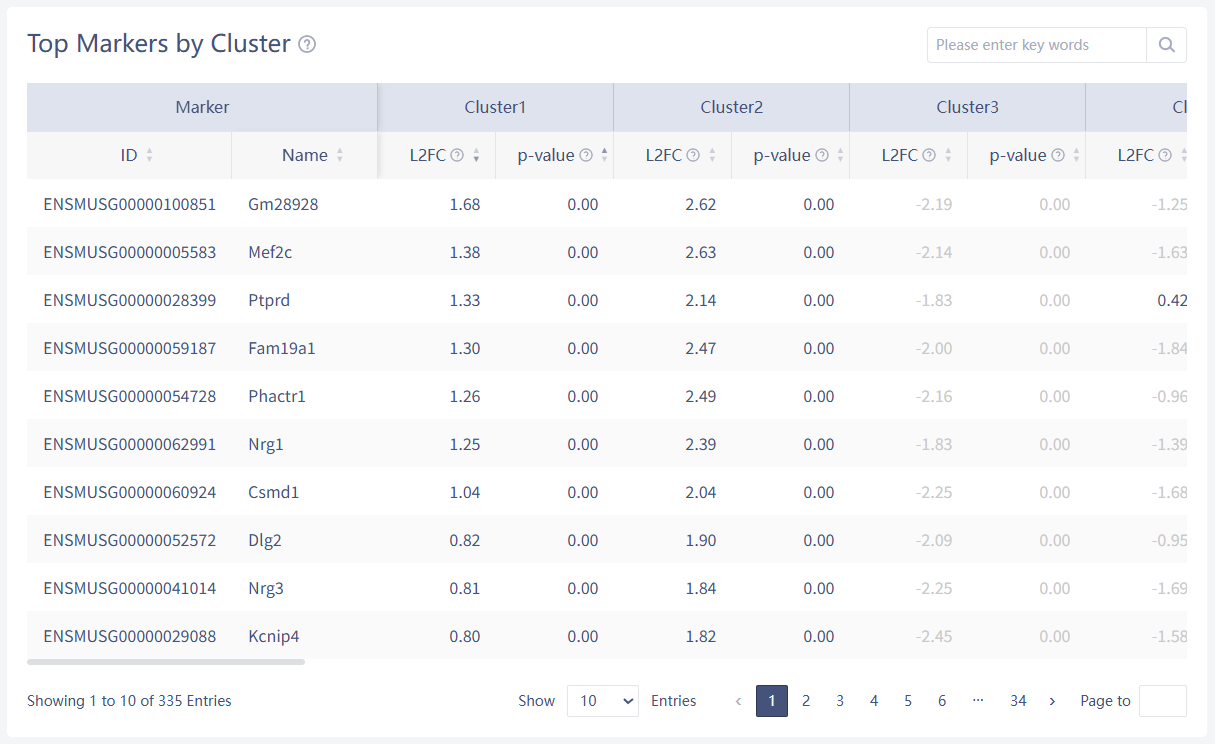
Marker feature table
差异表达分析的目的是识别在某个特定的聚类簇(cluster)中相比于样本其余区域表达量显著更高的标记物(marker 基因)。对于每个标记物,程序都会在该聚类簇与其余所有样本区域之间进行差异表达统计检验。
- Log2差异倍数 (Log2 fold-change, L2FC):对特定聚类簇与其他坐标区域之间基因表达比例的对数(以 2 为底)估算值。L2FC 值为
1.0代表该相关聚类簇内的基因表达量实际增加了 2 倍。 - p值 (p-value):基于负二项分布检验(Negative binomial test),p 值用于指示这种表达量差异的统计学显著性。
- 矫正p值 (Adjusted p-value):为了降低假阳性率,系统采用了 Benjamini-Hochberg 方法对多重假设检验的 p 值进行了校正。
此外,该表保留每个聚类簇中按照 L2FC 降序排列的前 N 个核心特征。表格中置灰的特征代表其矫正后的 p 值 >= 0.10 或 L2FC < 0(即在当前簇中不具备显著的上调特征)。
- N 的取值范围为 1 到 50,代表每个聚类簇显示的最显著特征数量。设置该值是为了将表格的总展示条目严格限制在 10,000 条以内。其具体计算公式为:,其中 为当前样本划分出的聚类簇总数。
- 可以点击表格的任意列标题进行排序,或利用搜索框直接检索感兴趣的目标基因。
与差异表达分析相关的特殊情况的解释可以在 Square Bin 部分下找到
图像
Summary
Image information
关于显微镜染色图像的基本信息,通常涉及显微镜设置。
QC
| Metric | Description |
|---|---|
| Image QC version | Image QC 模块的版本 |
| QC Pass | 图像是否通过了 Image QC 模块的算法质控检查 |
| Trackline Score | 一个参考评分,用于评估检测到的 tracklines 是否可被用于与基因表达矩阵的图像拼接和配准。(注意,该评分仅评估程序是否在图像中检测到了 tracklines,它并不被用于推断线条或图像的清晰度)。 |
Registration
| Metric | Description |
|---|---|
| ScaleX | 显微镜图像和 trackline 模板之间的水平缩放因子(由图像算法计算得出) |
| ScaleY | 显微镜图像和 trackline 模板之间的垂直缩放因子(由图像算法计算得出) |
| Rotation | 将显微镜图像映射到 trackline 模板上的 N 度旋转变换(由图像算法计算得出) |
| Flip | 图像是否被水平翻转 |
| Image X Offset | 显微镜图像和基因表达矩阵在水平方向上的偏移 |
| Image Y Offset | 显微镜图像和基因表达矩阵在垂直方向上的偏移 |
| Counter Clockwise Rotation | 逆时针方向的旋转角度 |
| Manual ScaleX | 显微镜图像和 trackline 模板之间的水平缩放因子(通过手动处理修改) |
| Manual ScaleY | 显微镜图像和 trackline 模板之间的垂直缩放因子(通过手动处理修改)。基于原始图像中心计算出的垂直缩放因子(手动配准) |
| Manual Rotation | 将显微镜图像映射到特征表达矩阵上的 N 度旋转变换(通过手动处理修改) |
| Matrix X Offset | 特征表达矩阵的 X 轴起点 |
| Matrix Y Offset | 特征表达矩阵的 Y 轴起点 |
| Matrix Height | 特征表达矩阵的高度 |
| Matrix Width | 特征表达矩阵的宽度 |
Tissue detection and alignment
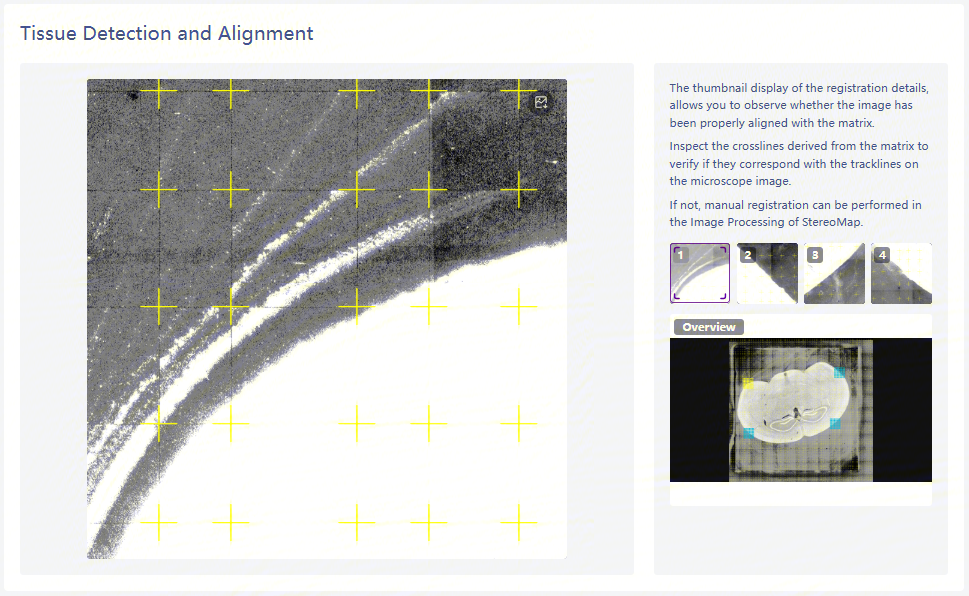
Observation of alignment between matrix and image
这些缩略图是检测到的组织区域的四个角落,配准细节的缩略图展示可以观察图像是否与矩阵正确对齐。检查由矩阵导出的十字线,以验证它们是否与显微图像上的 tracklines 相对应。
微生物
Summary
这是另一个专门用于微生物分析的小鼠肺部 FFPE 组织样本
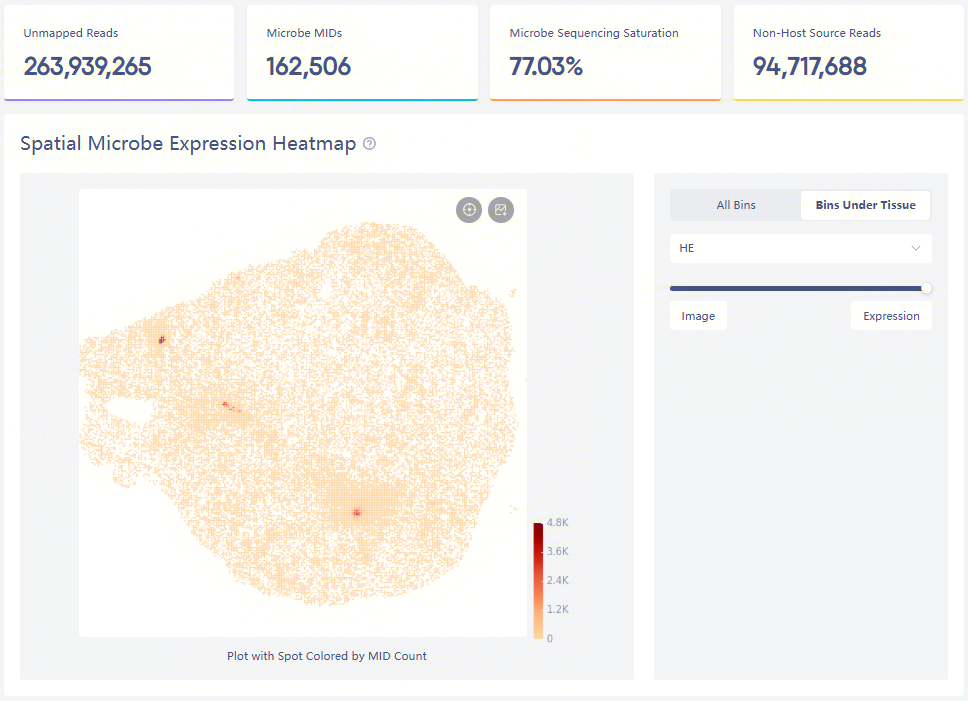
Microorganism heatmap under tissue region and four key metrics
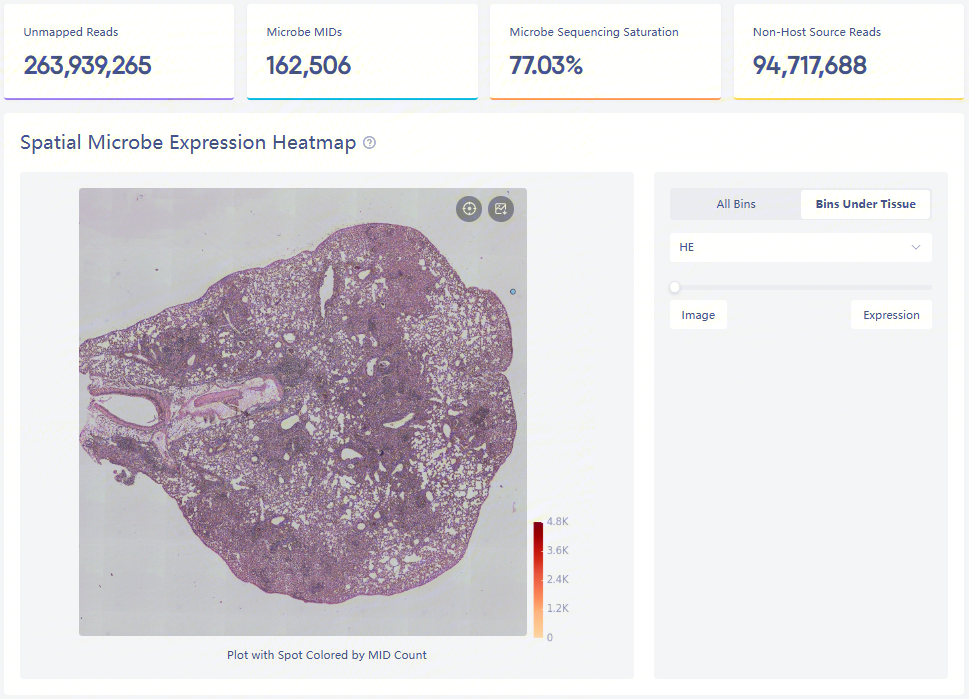
Display of microscope image
左侧的微生物空间表达分布图,显示了 bin50 维度下的 MID 计数
Microbe key metrics
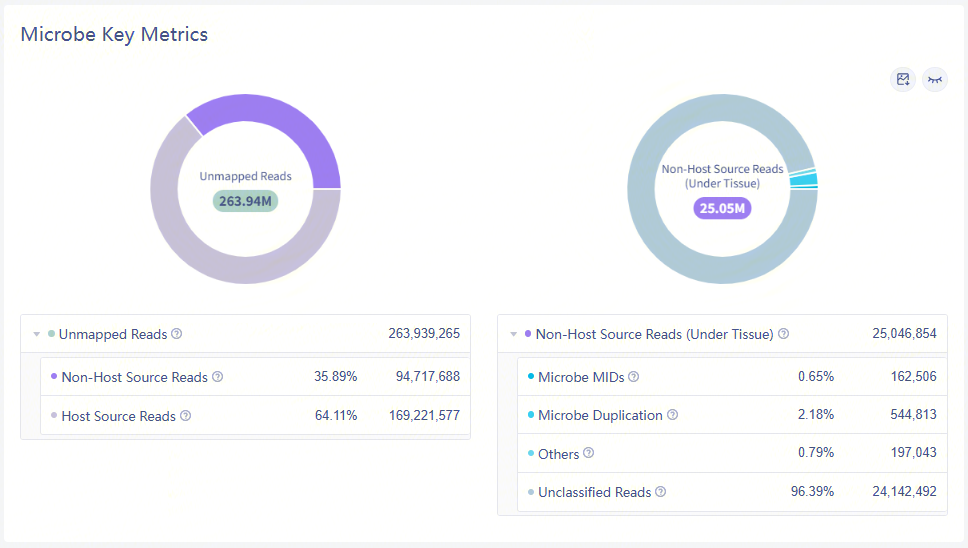
Mapping results of Bowtie2 and Kraken2
| Metric | Description |
|---|---|
| Unmapped Reads | Unmapped Reads 产生于转录组比对,作为微生物检测的输入数据 |
| Non-Host Source Reads | 无法比对到宿主基因组的 reads 数量。降噪过程是使用 Bowtie2 进行的 |
| Host Source Reads | 在降噪期间可以比对到宿主基因组的 reads 数量 |
| Non-Host Source Reads (Under Tissue) | 无法比对到宿主基因组且位于组织检测区域内的 reads 数量。降噪过程是使用 Bowtie2 进行的 |
| Unclassified Reads | 基于输入的分类数据库无法分类的 reads 数量 |
| Microbe MIDs | 比对到细菌、真菌或病毒的 MID 数量 |
| Microbe Duplication | 比对到细菌、真菌或病毒且由于重复 MID 被校正的 reads 数量 |
| Others | 比对到除细菌、真菌和病毒以外的其他微生物或宿主可疑区域的 reads 数量 |
Top 10 Phyla
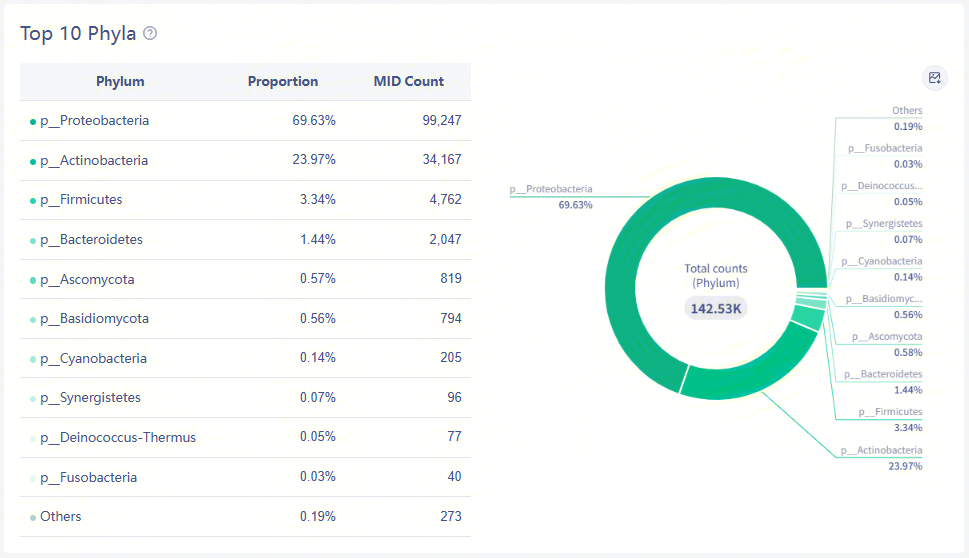
Microbes proportion at phylum level
在门级别的微生物主要占比。
*其他分类级别同理
蛋白
Summary
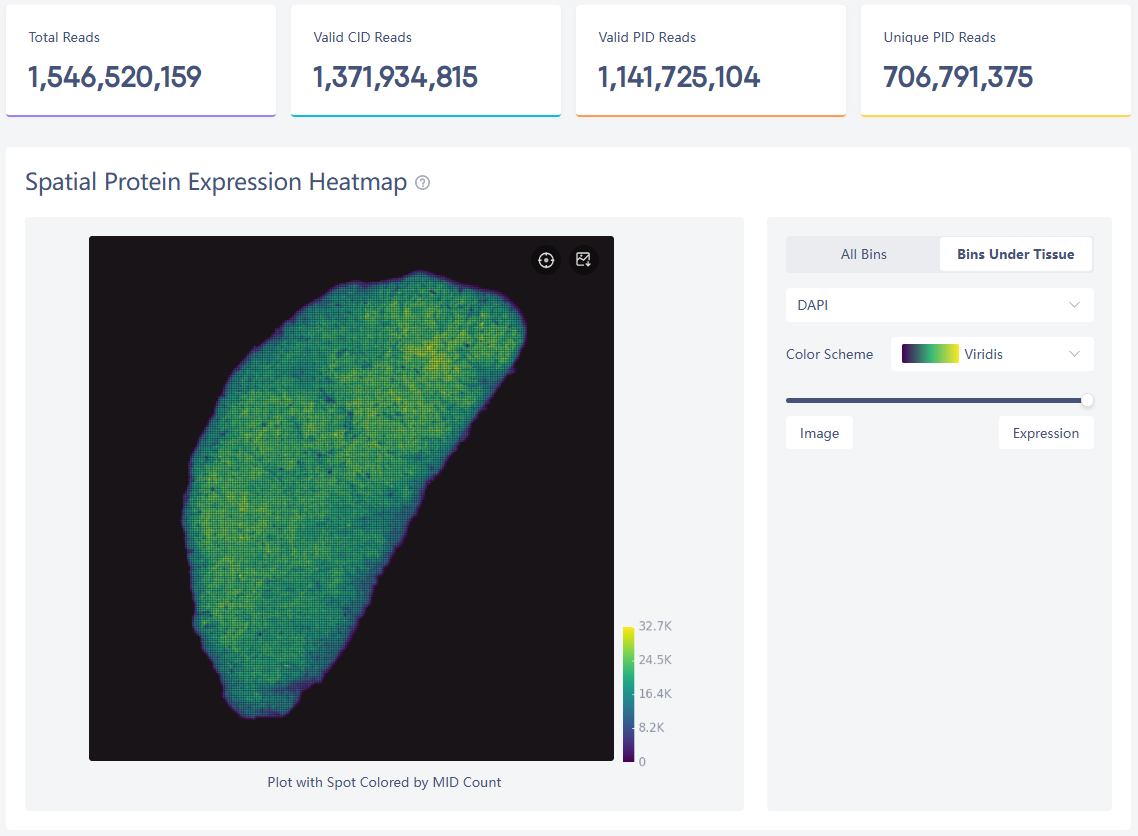
Expression heatmap and four key metrics
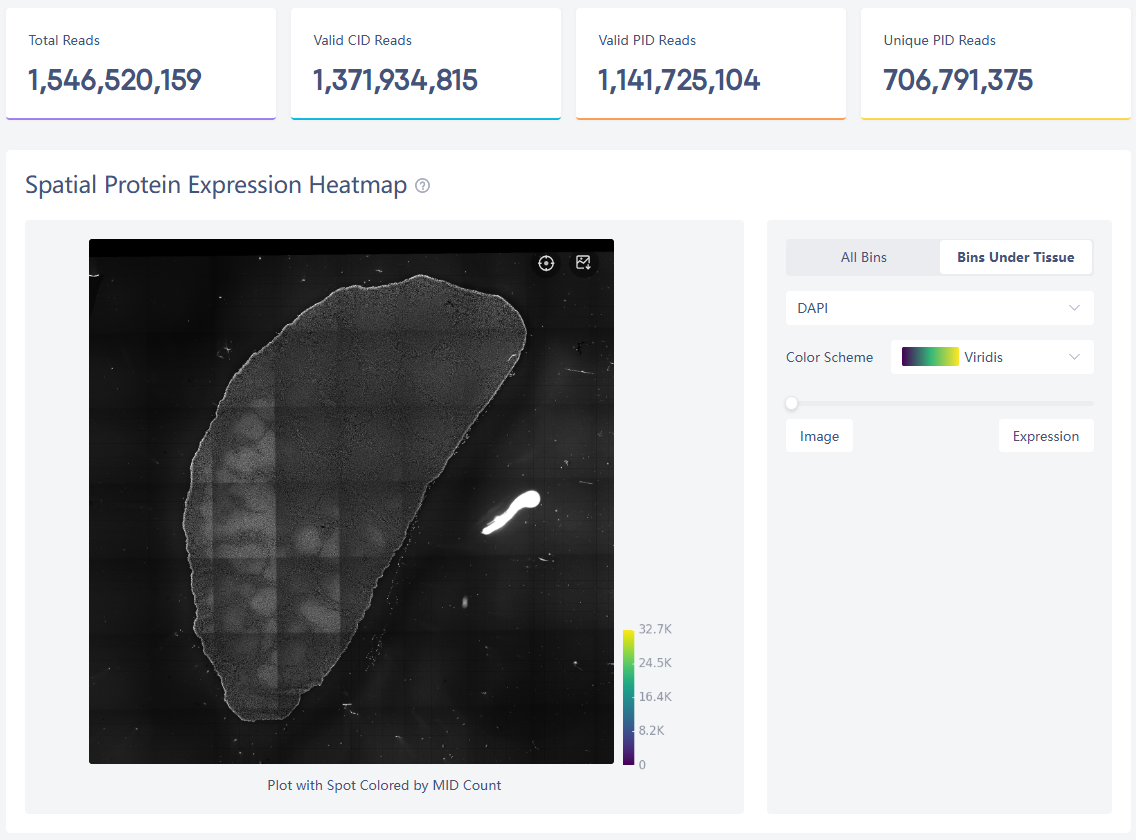
Display of microscope image
左侧的空间蛋白表达分布图,包含了所有的 Bin 以及组织区域下的 Bin,显示了在每个 bin200 下的 MID 计数。
- Total Reads: 输入测序 ADT FASTQs 的总测序 reads 数
- Valid CID reads:CID 比对成功并且 MIDs 通过 QC 的 reads 数量
- Valid PID reads:比对到蛋白 Panel 中 PID 序列的 reads 数量
- Unique PID reads:unique 蛋白 reads 的总数量(PID 比对成功,但 MID 不同的reads)
Protein key metrics
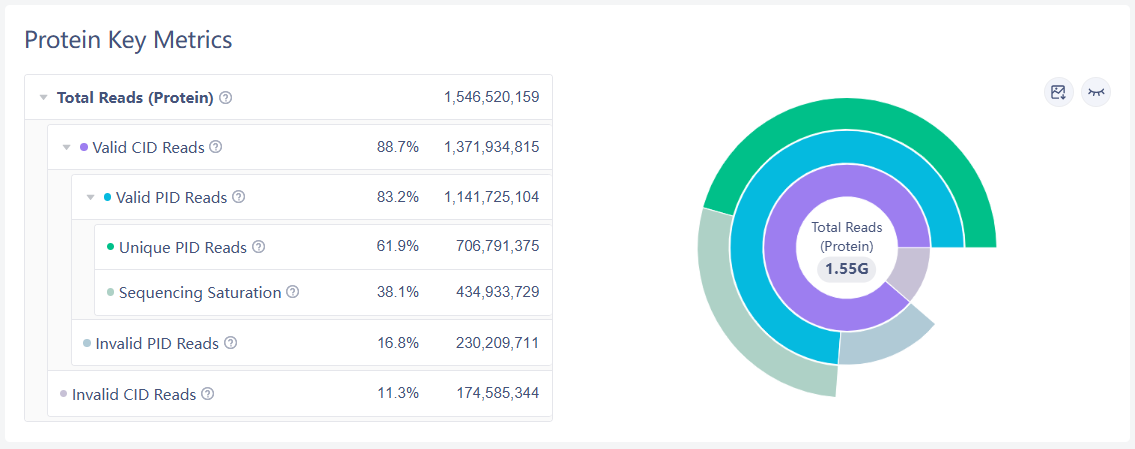
Details and sunburst plot of key metric
蛋白组的统计指标信息:
| Metrics | Description |
|---|---|
| Total Reads (Protein) | 蛋白质组测序 reads 总数量 |
| Valid CID Reads | Stereo-seq 芯片匹配的 CID(坐标 ID)序列的 reads 数量 |
| Invalid CID Reads | 无法与 Stereo-seq 芯片匹配的 CID(坐标 ID)序列的 reads 数量 |
| Valid PID Reads | 基于输入的 PID 列表,可以被映射到 PID(蛋白 ID)序列的 reads 数量 |
| Invalid PID Reads | 基于输入的 PID 列表,无法被映射到 PID(蛋白 ID)序列的 reads 数量 |
| Unique PID Reads | 在 PCR 去重后映射到 PID(蛋白 ID)列表的蛋白 reads 数量,带有唯一的 PID、CID(坐标 ID)和 MID(分子 ID) |
| Sequencing Saturation | 具有 PCR 重复的蛋白 reads 数量 |
Sequencing saturation
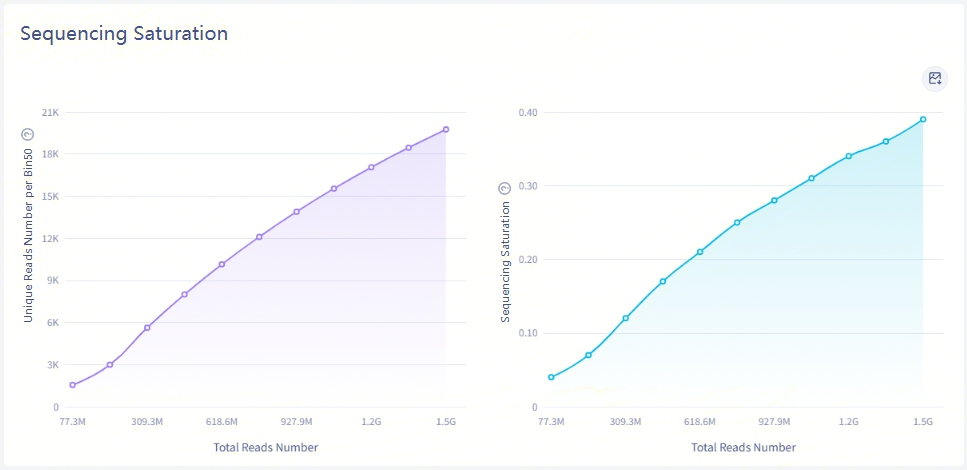
Sequencing saturation curves
HTML 报告中的饱和度分析可评估测序数据的整体质量。为了提高计算效率,程序会在 bin20 或 bin50 维度成功注释的 Reads 中随机抽取小样本。因此,同一数据的多次运行结果可能会有微小差异。计算公式可能不完全相同,但曲线的总体形状保持一致。
- 图 1:基于随机抽样样本中的 Unique Reads 数据拟合出的曲线。
- 图 2:抽样样本中 Unique Reads(具有唯一 CID、PID 和 MID 的 Reads)的统计,饱和度值 = 1-(Unique Reads)/(Valid PID Reads),随着采样量增加,拟合曲线变得几乎平坦,表明数据趋于饱和。
是否需要增加额外的测序取决于整体项目设计和样本情况。例如,建议对珍贵样本进行加测。报告中 0.8 的阈值仅作为推荐指导的提醒。
Protein correlations
组织区域下原始抗体计数之间的 Spearman 相关性( bin50 下),除 isotype 外。抗体是基于 Spearman 相关系数聚集的。
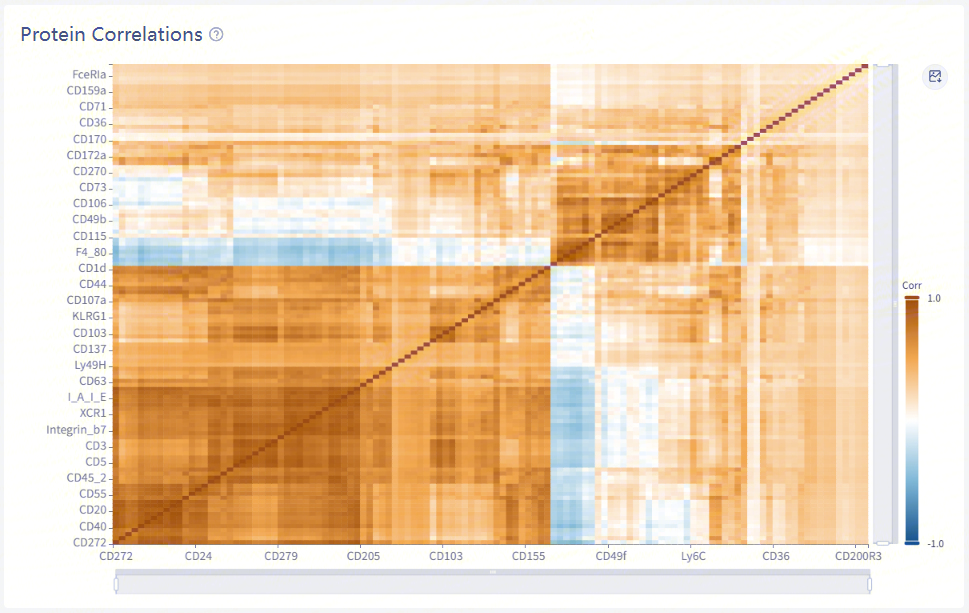
Correlation plot within protein-protein
Gene : protein correlations
组织区域下原始基因计数与原始抗体计数之间的 Spearman 相关性( bin50 下),其中抗体在蛋白 panel 中至少具有一个 marker 基因。
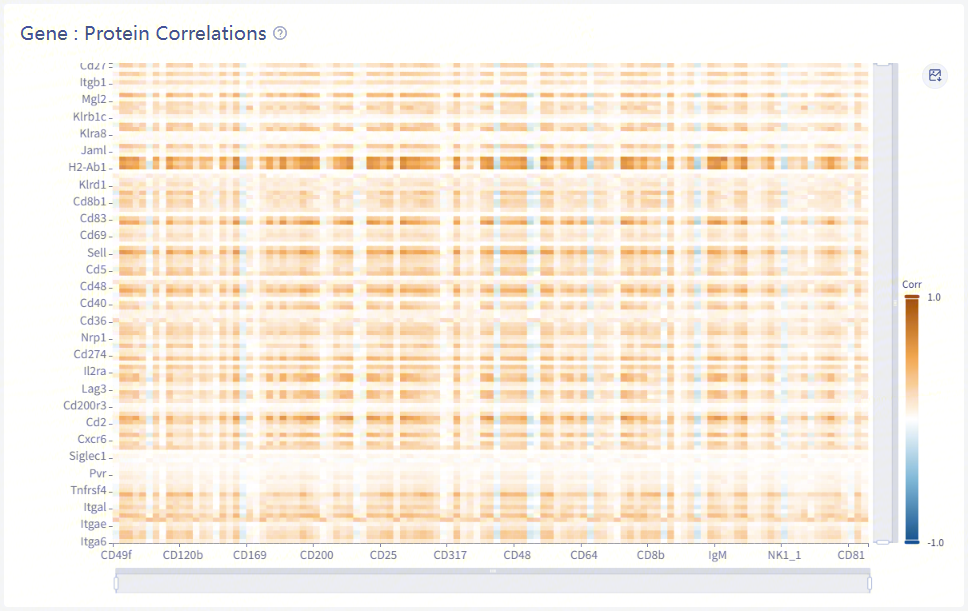
Correlation plot within gene-protein
Histogram of protein counts
Spot 数量 vs log 转换后 MID 计数的分布(在 bin50 下)
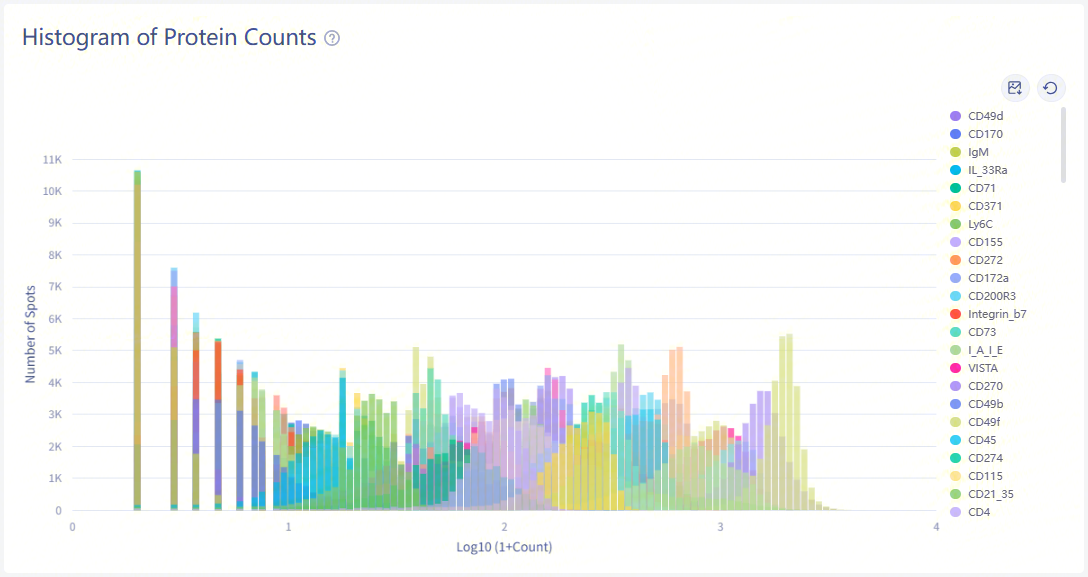
Histogram plot between spot numbers and log-scaled MID count
Sample information
输入数据集的基本信息:
| Metric | Description |
|---|---|
| Sample ID | HTML 报告的 ID |
| Organism | 样本的物种信息 |
| Tissue | 样本的组织类型 |
| Reference | 用于 Reads 比对和注释的参考基因组 |
| Kit Version | Stereo-seq 产品试剂盒的版本 |
| Sequencing Type | Stereo-seq 产品试剂盒的测序类型 |
| Stereo-seq Chip SN | Stereo-seq 芯片的序列号 |
| FASTQ | 输入 FASTQ 文件的详细信息 |
Square Bin
此页面包含在 bin 维度的统计、图表、聚类、UMAP 和差异表达分析结果,结果基于 <SN>.protein.tissue.gef 文件分析计算得出, 页面默认显示 bin20 和 bin50 的分析结果,这取决于启动 saw count/realign 时设置的 --custom-bin-size。
Statistics
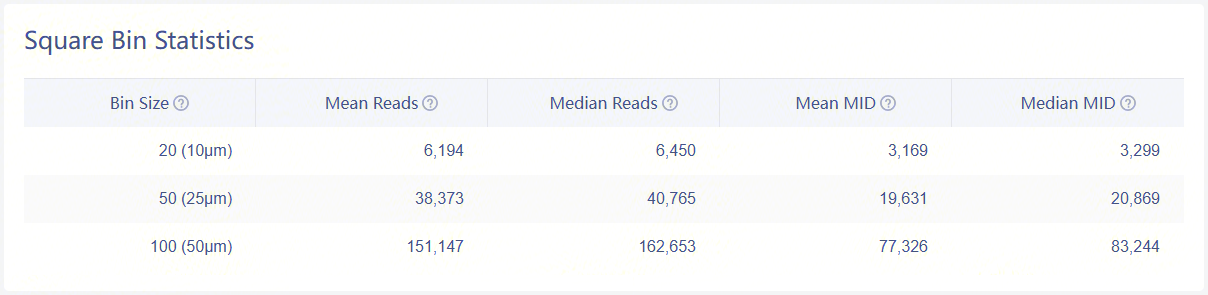
Statistics of bins under tissue-coverage region
| Item | Description |
|---|---|
| Bin Size | 一个单位 bin,被称为表达 spot,用于在方形区域内聚合 DNBs(在 Stereo-seq 芯片上)(例如,bin20 = 20 x 20 DNBs) |
| Mean Reads (per bin) | 一个 binN 内(组织区域下)测序 Reads 的平均数量 |
| Median Reads (per bin) | 一个 binN 内(组织区域下)测序 Reads 的中位数量 |
| Mean MID (per bin) | 一个 binN 内(组织区域下)MID 平均量 |
| Median MID (per bin) | 一个 binN 内(组织区域下)MID 中位量。 |
Plots
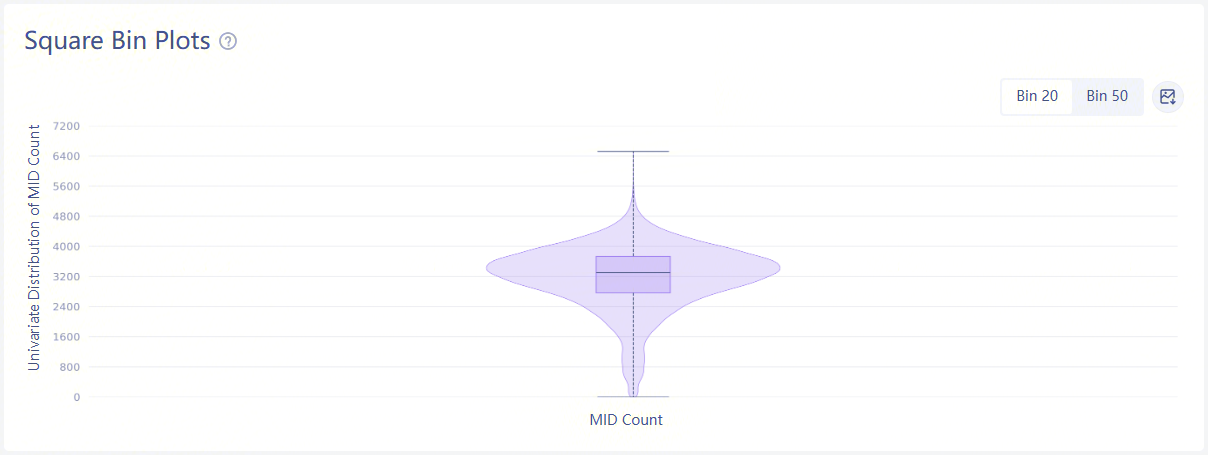
Distribution plots of MID
小提琴图显示了每个 bin 中去重后的 MID 计数的分布。
Clustering & UMAP
Leiden clustering and UMAP projection
聚类分析是基于 SN.protein.tissue.gef ,使用 Leiden 算法计算得出的。UMAP 降维投影是基于 SN.protein.tissue.gef 计算得出的,并通过自动聚类进行着色,即距离较近且具有相似基因表达谱的 Spot 会被分配相同的颜色。
Cell Bin
此页面包含在 cellbin 维度的统计、图表、聚类、UMAP 和差异表达分析结果。细胞边界外扩在 SAW count 和 SAW realign 期间是自动执行的,意味着 "Cell Bin" 选项卡的内容是基于 SN.protein.adjusted.cellbin.gef 的。
当 saw realign 设置 --adjusted-distance=0 时,此选项卡的所有内容都是基于 SN.protein.cellbin.gef 的。
Statistics
Detailed statistics of cellbin
Cellbin 维度的统计指标信息:
| Item | Description |
|---|---|
| Cell Count | 检测到的细胞总数(MID 计数 >= 1) |
| Mean Cell Area | 细胞面积平均值(单位:μm²) |
| Median Cell Area | 细胞面积中位数(单位:μm²) |
| Mean MID | 每个细胞的 MID 平均计数 |
| Median MID | 每个细胞的 MID 中位计数 |
Plots
Distribution plots of MID and cell area
提琴图显示了 cellbin 中去重后的 MID 计数和细胞面积的分布。
Clustering & UMAP
Leiden clustering and UMAP projection
聚类分析是基于 SN.protein.adjusted.cellbin.gef 或 SN.protein.cellbin.gef ,使用 Leiden 算法计算得出的。UMAP 降维投影是基于 SN.protein.adjusted.cellbin.gef 或 SN.protein.cellbin.gef 计算得出的,并通过自动聚类进行着色,即距离较近且具有相似基因表达谱的 Spot 会被分配相同的颜色。
指标预警
软件为重要的统计指标设置了阈值。如果分析结果出现异常,将在 HTML 报告顶部显示警告信息。
这仅是一个为展示而准备的异常数据样例。
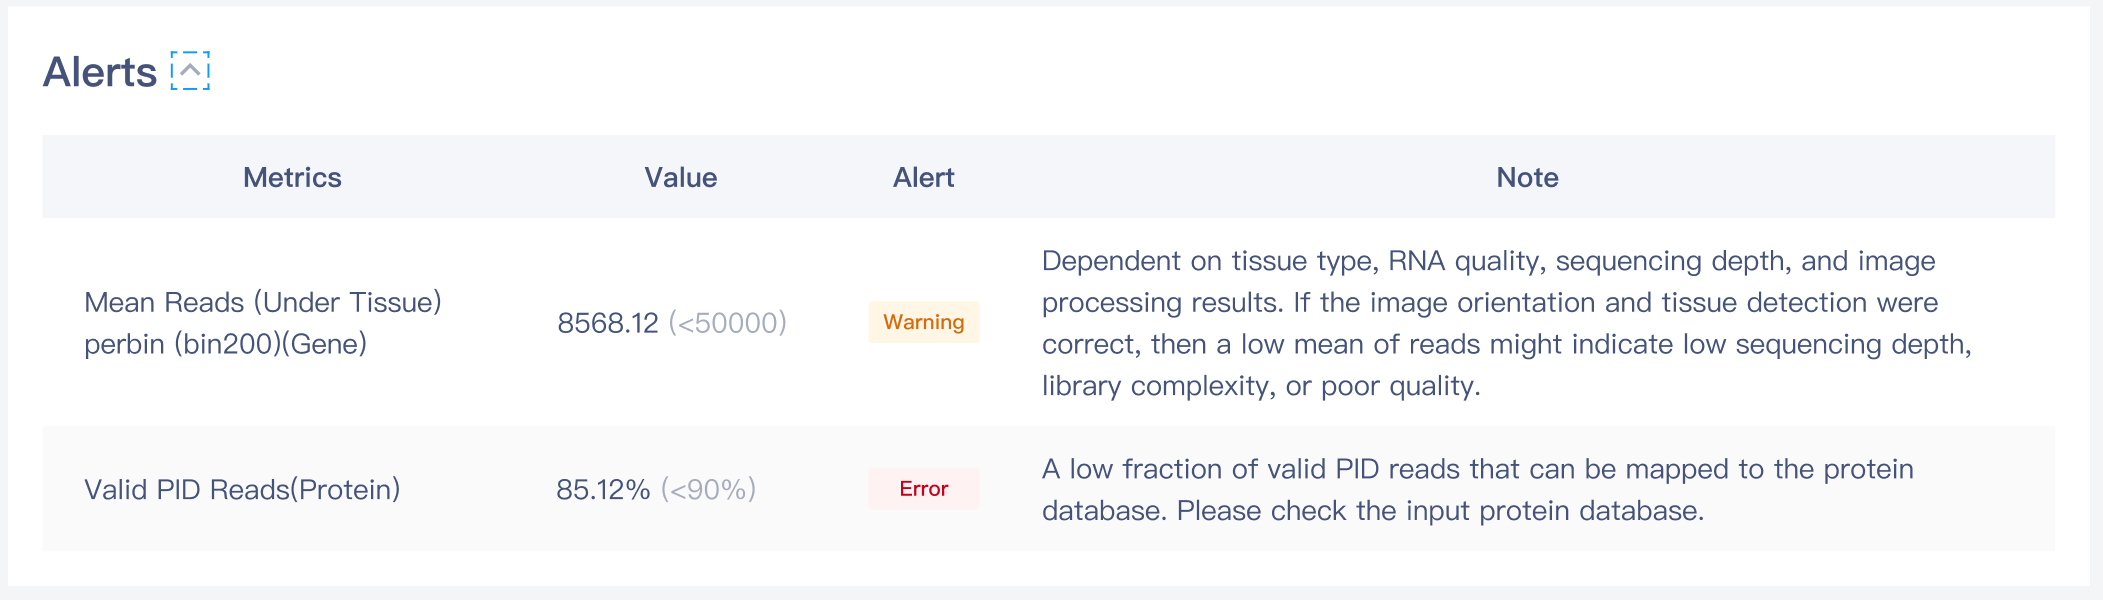
Alert information
多片分析报告
概览
由 saw aggr 生成的 <id>.report.html 文件是一个基于网页的交互式报告。该报告提供了多样本数据聚合、批次效应校正以及联合聚类结果的全面可视化。内容组织为五个核心部分:
样本信息
第一部分展示了聚合任务的基本配置以及所有输入样本的初始状态。
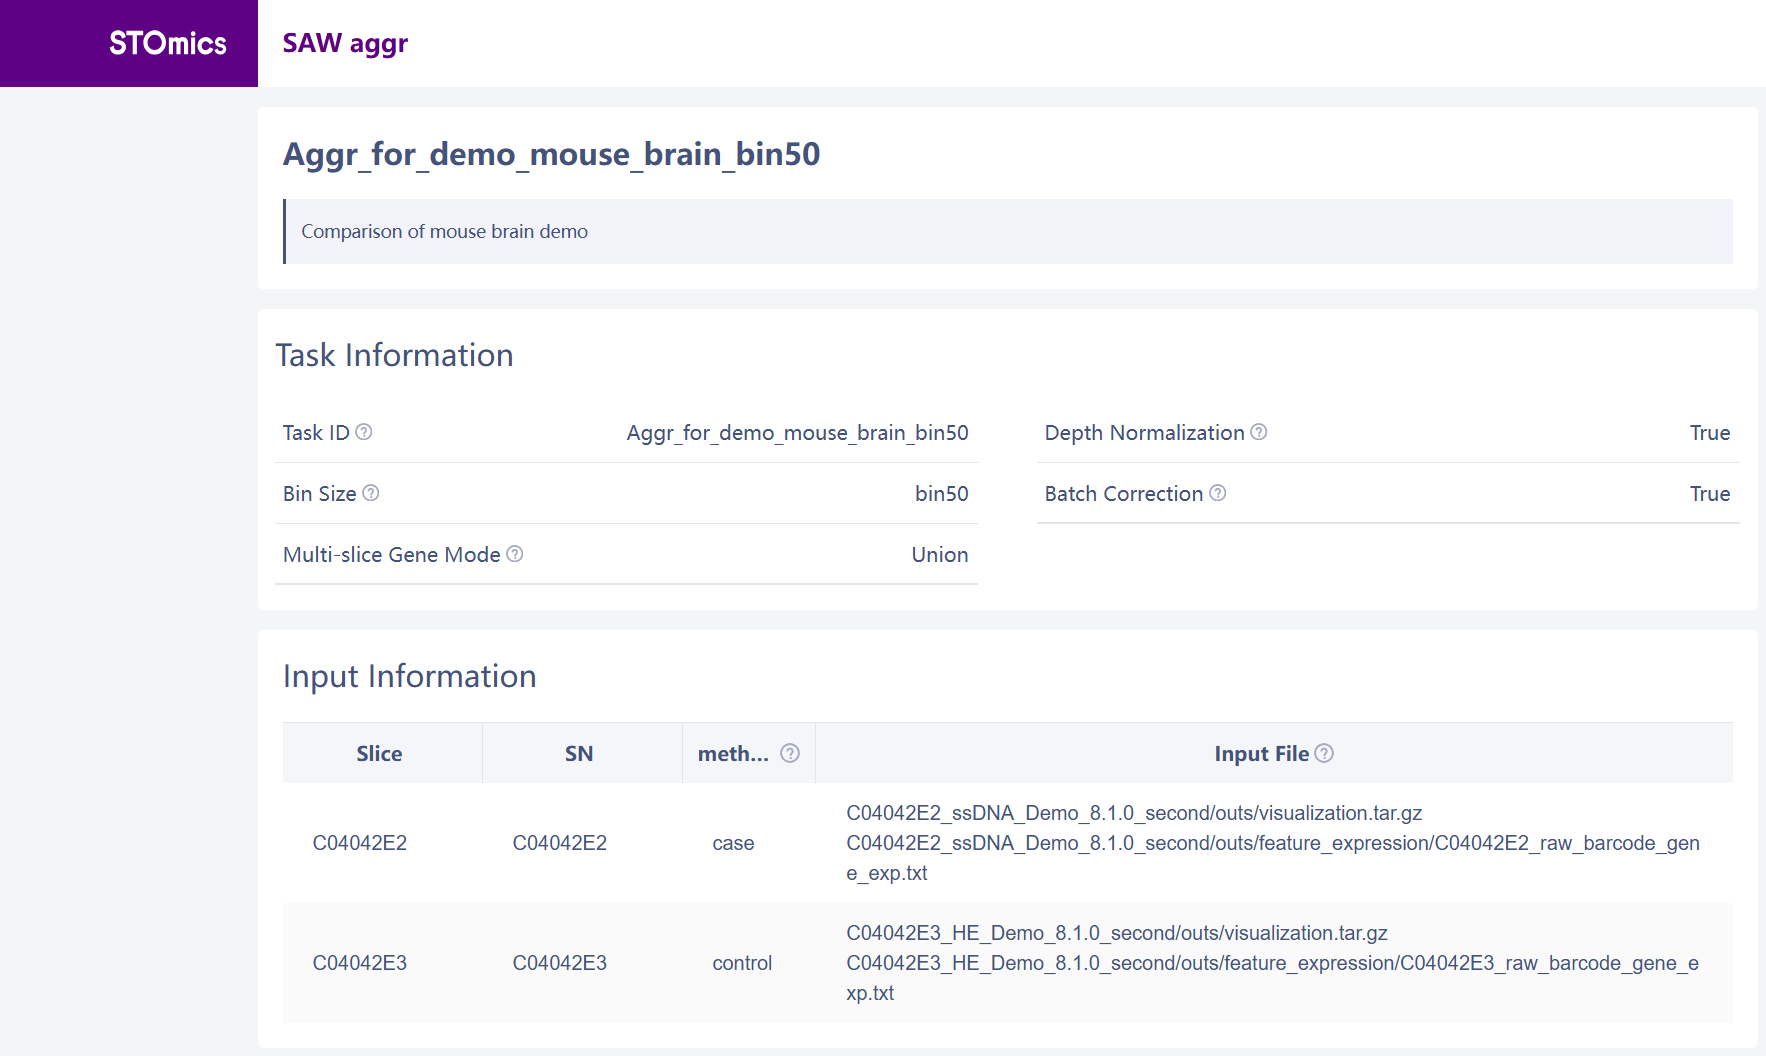
Basic information
测序深度归一化
第二部分重点关注测序深度归一化的效果:
- Before Normalization: 显示每个样本的原始 reads分布。由于测序深度的不同,中位数可能会有显著差异。
- After Normalization: 显示全局归一化后的 reads分布。在理想状态下,所有样本的中位数应当对齐。
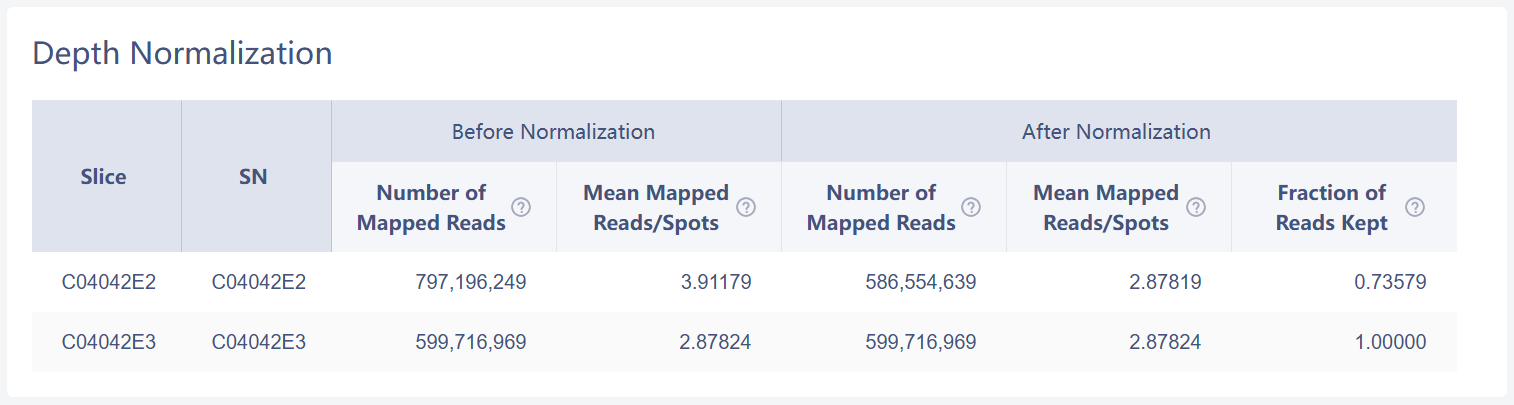
Comparison of depth normalization
批次效应校正
第三部分使用 UMAP 图来直观比较批次效应校正前后样本的分布,是评估整合质量的关键指标。
- Uncorrected: 显示合并原始数据的 UMAP。如果 spots 根据样本来源清晰分离(即,不同的颜色形成孤立的簇),则存在强烈的批次效应。
- Corrected: 显示应用批次校正算法后的 UMAP。
成功的整合应显示来自不同样本的 spots 在同一个细胞类型簇中充分混合,这表明在去除了技术批次效应的同时保留了生物学的异质性。
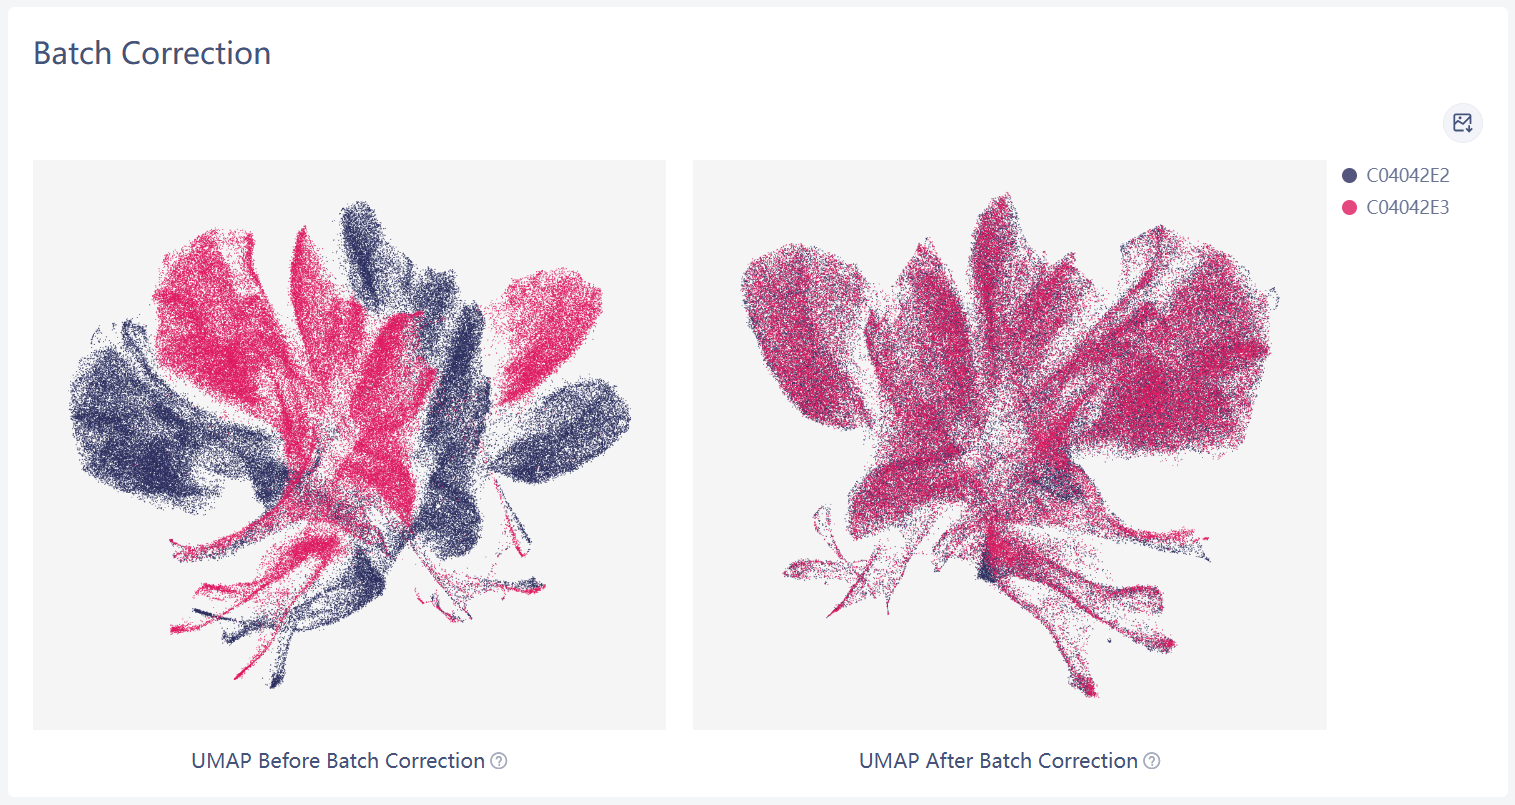
Comparison of UMAP distribution
聚类
这部分显示基于聚合数据集的聚类结果。
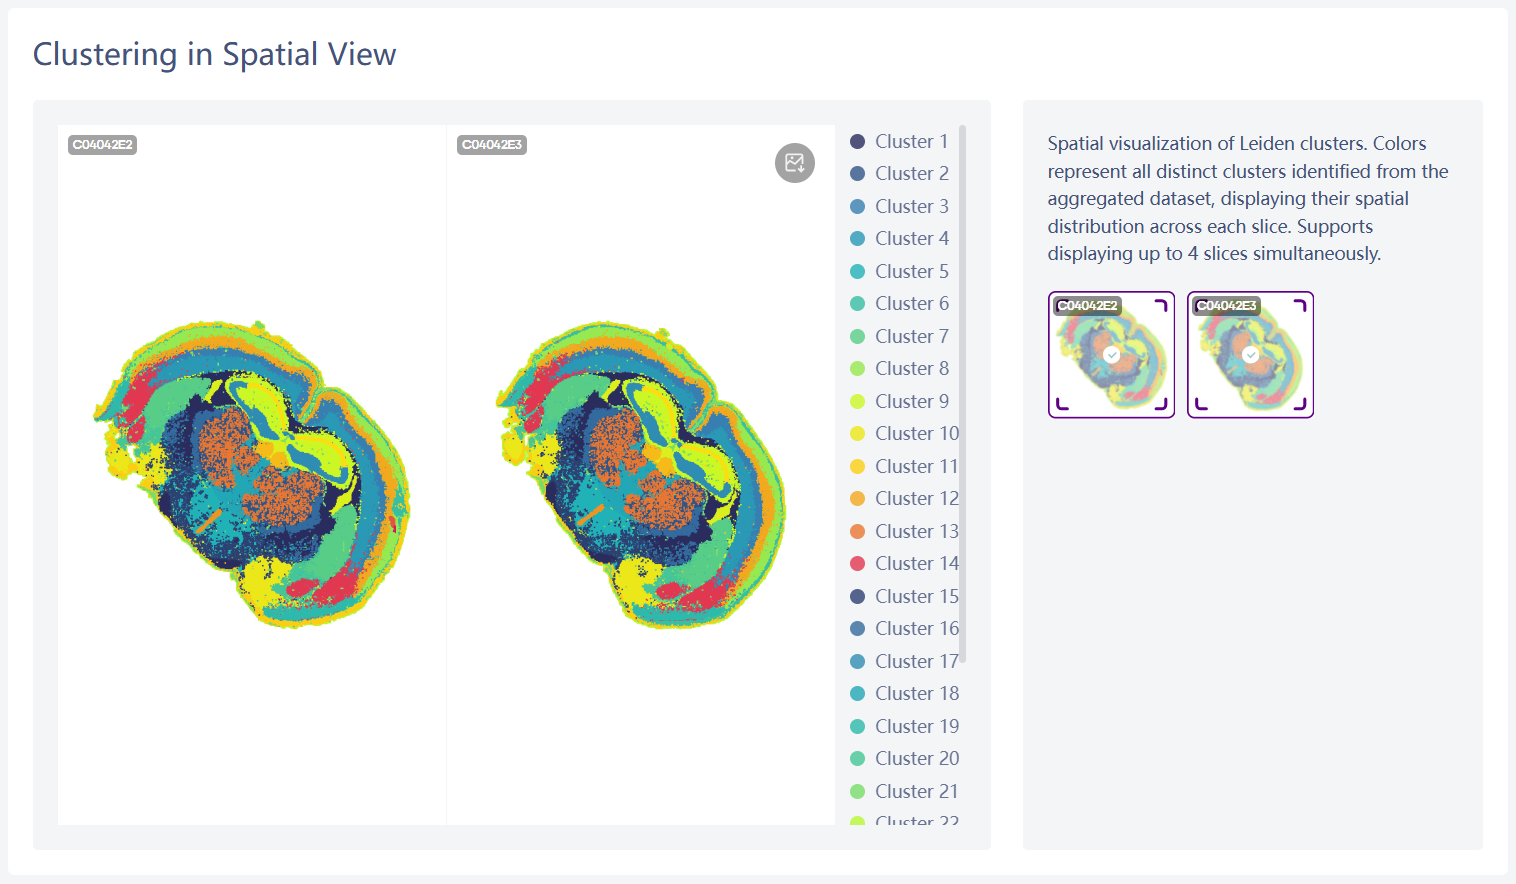
Spatial distribution of clustering
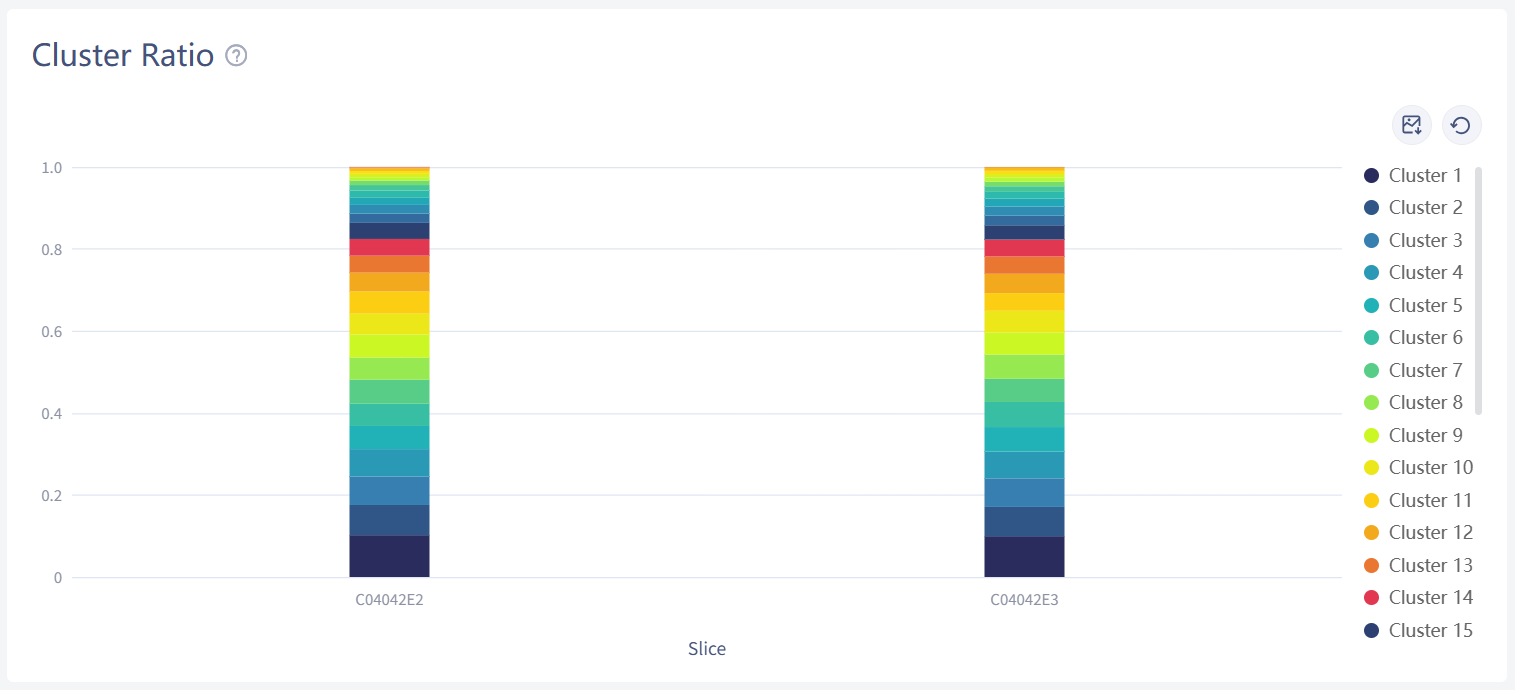
Ratio of Leiden clusters within each sample
差异表达分析
此部分整合了来自两个不同维度的差异基因挖掘结果:
- 聚类标记物 (簇间)
识别可区分某一特定簇与所有其他簇的 Marker 基因,以定义每个簇的生物学身份。
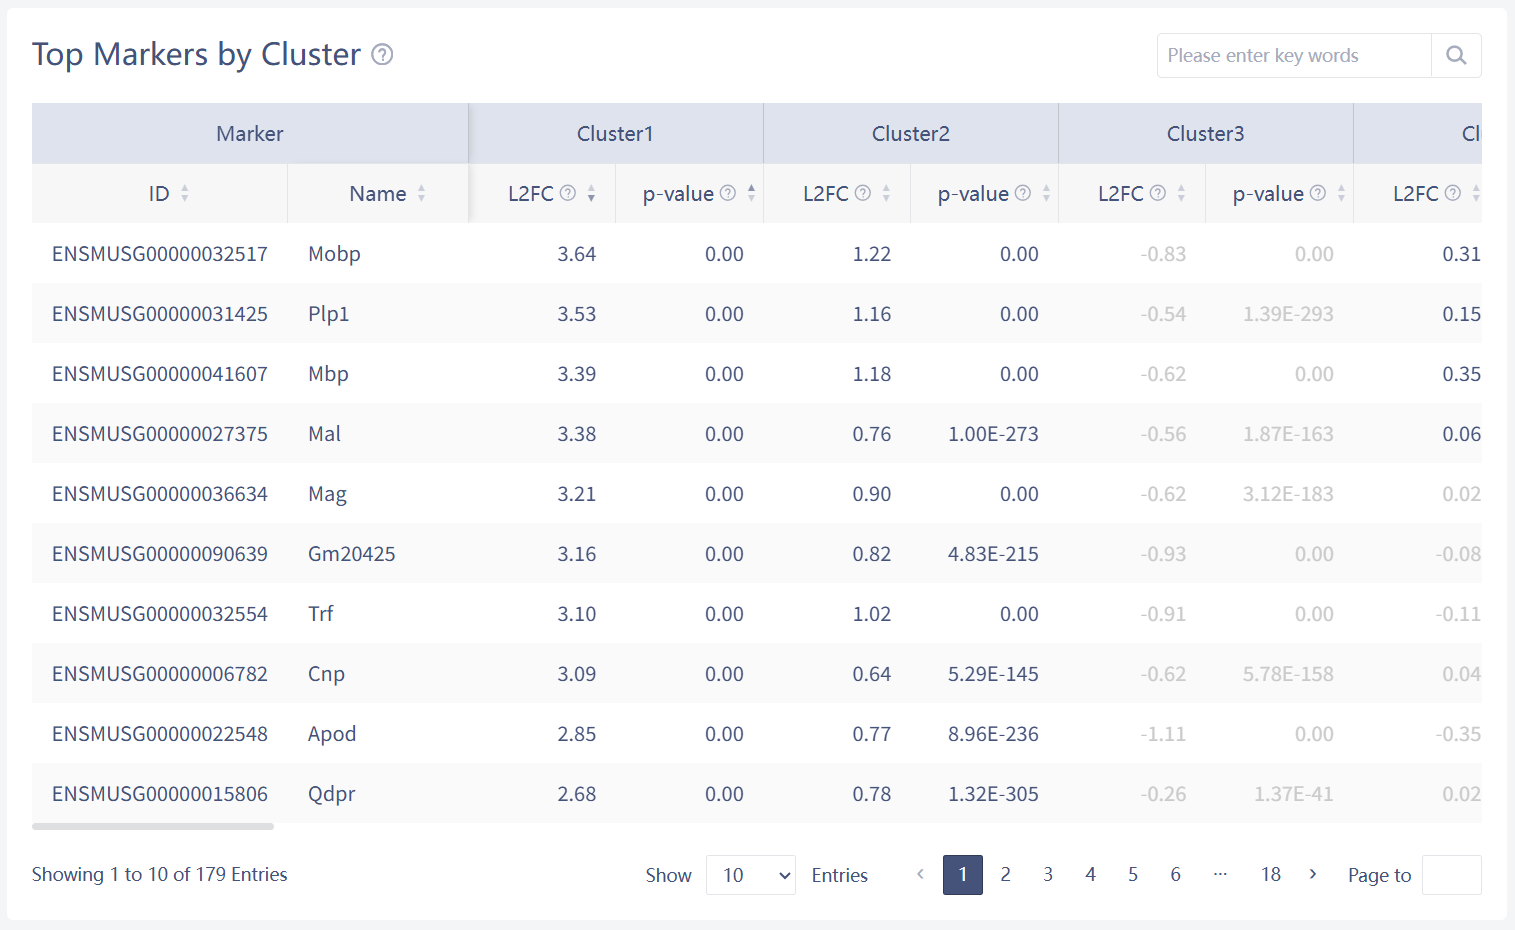
- 组间差异表达基因 (簇内组间)
比较特定 Leiden 簇内用户定义分组(如由 --deg-group-by 所指定的,例如 Treated vs. Control)之间的表达谱,以识别特定细胞类型下条件特异性的分子变化。(例如,“与对照组相比,疾病组神经元中的哪些基因被特异性上调?”)