
数据再分析
本教程将将展示如何运行辅助分析流程 saw reanalyze,进行
cluster聚类分析lasso区域的表达矩阵提取diffExp差异表达分析coExp空间基因共表达分析multiomics蛋白组&转录组联合分析midFilter基于自定义MID范围过滤矩阵removeBackground自动去除蛋白背景信号
从 8.3 版本开始,SAW 正式发布了 saw aggr 多片分析功能,以支持多样本的整合分析。现在,cluster、lasso 和 diffExp 模块对应全面升级,以支持多样本场景。这一增强功能允许用户无缝地跨越多个样本执行整合聚类、区域框选及差异表达分析。
cluster 和 multiomics 模块现在支持 GPU 加速(设置 --gpu-id),从而显著提升分析速度。
- 前提条件: 此功能依赖 GPU 加速插件,在运行分析之前,请通过
saw support安装该插件,具体说明请参阅下载中心 - 更多信息: 请查阅 高级设置/Analysis with GPU
聚类分析
在生信下游分析中,聚类是一种关键且基本的算法处理,可将具有相似特征的空间表达点归为同组,该过程有助于揭示表达数据中的底层结构和模式。
在进行分析前,需要根据数据的物种和组织类型来选择合适的 bin size 例如,哺乳动物细胞的直径约为 10 µm,DNB 的物理间距为 500 nm,因此 bin20 会是一个合适的选择。
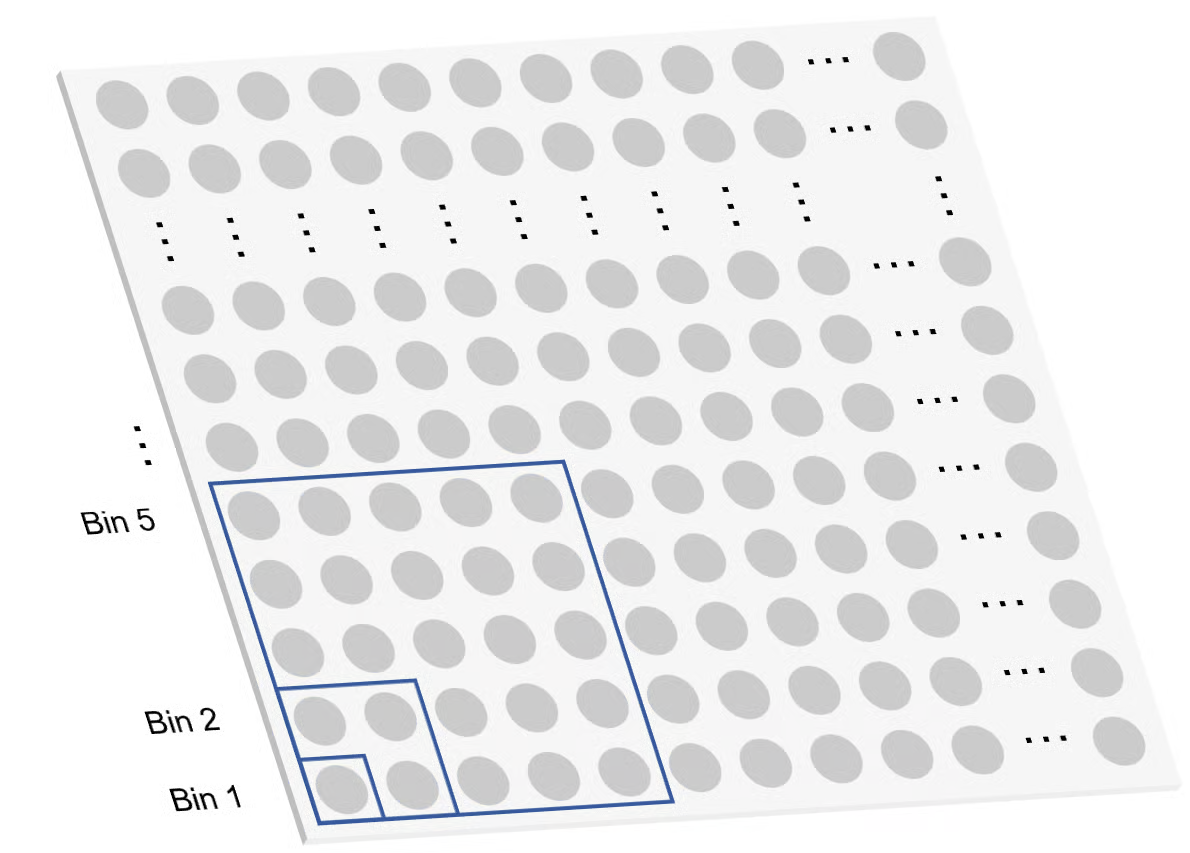
Different bin levels on the expression matrix
调用 Leiden 算法 进行聚类时,--Leiden-resolution 参数的默认值为 1.0,它可以调控 Leiden 聚类时的分群颗粒度,值越大,分群簇越多。并且,可以开启 --marker 参数,基于 Leiden 算法的分群结果进行差异表达分析。
如果使用 bin GEF 进行聚类,运行命令如下:
saw reanalyze cluster \
    --gef=/path/to/input/GEF \
    --bin-size=20 \
    --Leiden-resolution=1.0 \
    --marker \
    --output=/path/to/output/clustering
基于 bin GEF 的聚类输出如下:
clustering
├── <SN>.bin20_1.0.h5ad  ##<SN>.<bin_size>_<resolution>.h5ad, containing analysis results
├── find_marker_genes.csv  ##original output CSV
└── bin20_marker_features.csv  ##formatted CSV for visualization in StereoMap
在运行分析时开启 --marker ,将获得与差异表达分析相关的结果,即 find_marker_genes.csv 和 <bin_size>_marker_features.csv。
find_marker_genes.csv是原始差异分析结果文件。<bin_size>_marker_features.csv是一个经过格式调整CSV,记录了每个类群的平均 MID count、L2FC、校正后的 p-value 和基因在类群内的表达占比等。
如果使用 cellbin GEF 进行聚类,运行命令如下:
saw reanalyze cluster \
    --cellbin-gef=/path/to/input/cellbin/GEF \
    --Leiden-resolution=1.0 \
    --marker \
    --output=/path/to/output/clustering
基于 cellbin GEF 的聚类输出如下:
clustering
├── <SN>.cellbin.gef  ##a copy of input cellbin GEF but with new clustering information
├── <SN>.cellbin_1.0.h5ad  ##<SN>.cellbin_<resolution>.h5ad, containing analysis results
├── find_marker_genes.csv  ##original output CSV
└── cellbin_marker_features.csv  ##formatted CSV for visualization in StereoMap
图像嵌入
cluster 模块现在支持将显微镜图像嵌入到输出的 AnnData H5AD 文件中。这使得空间表达矩阵能够无缝叠加到组织形态上,从而便于进行直观的下游可视化与验证。
建议:请输入自定义图层名称 (layer name) 的已配准图像,确保图像与表达矩阵的精确对齐,并在可视化过程中易于识别。
saw reanalyze cluster \
    --gef=/path/to/input/GEF \
    --bin-size=20 \
    ...
    --output=/path/to/output/clustering_with_img \
    --image=/path/to/registered/microscope/image/tiff \
    --layer=<layer_name>

#the same to cellbin GEF
嵌入的图像数据存储在 H5AD 文件内部的 /uns/spatial/<layer_name> 组中:
$ h5dump -n ./output_with_image.h5ad
HDF5 "/output_with_image.h5ad" {
FILE_CONTENTS {
 group      /
 group      /X
 ...
 group      /uns/spatial
 group      /uns/spatial/<layer_name>
 group      /uns/spatial/<layer_name>/...
 ...
多样本场景
若要跨多个样本执行聚类和差异表达分析,需要基于 H5MU 文件进行分析。.h5mu 格式封装了整合多样本的数据集,将其作为识别跨样本聚类的标准输入文件。
saw reanalyze cluster \
    --h5mu=/path/to/input/H5MU \
    --Leiden-resolution=1.0 \
    --marker \
    --output=/path/to/output/reclustering
输出的 H5MU 文件的 Bin 大小与输入文件保持一致。基于 H5MU 进行聚类的输出结果目录结构如下所示:
reclustering
├── <file_prefix>.binN_1.0.h5mu
├── <file_prefix>.binN_1.0_marker_features.csv
└── <file_prefix>.binN_1.0_find_marker_genes.csv
矩阵套索
StereoMap 中的交互式工具可以 lasso (手动圈选)感兴趣区域,它需要 saw reanalyze 分析流程来协助将 lasso GeoJSON 中区域信息转化为特征表达矩阵。
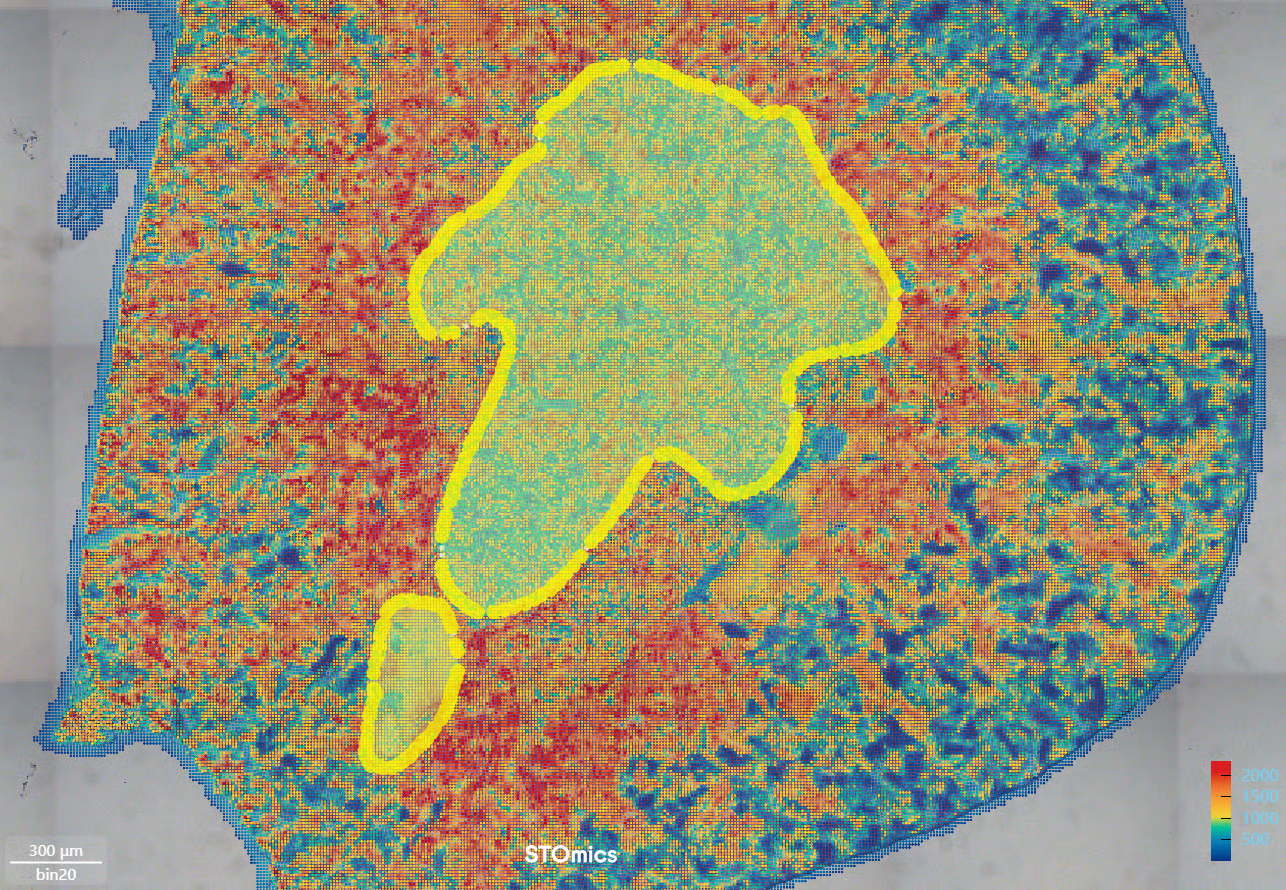
Lasso in StereoMap
从 StereoMap 4.3 开始,套索选择 (Lasso selection) 和差异表达分析记录的输出文件已标准化为 CSV 格式。虽然这两种格式(CSV 和 GeoJSON)都用于存储标签信息,但它们在数据表示方式上存在本质区别:
- CSV(基于点位 / Point-based): 每一行代表一个单一的坐标点 (x, y),明确列出了它的坐标位置以及被分配的标签 ID。它属于原始的、高分辨率的数据。
- GeoJSON(基于轮廓 / Contour-based): 定义了每个标签区域的边界轮廓(多边形 / polygons)。它侧重于描述区域的总体形状和范围,而不是逐一单独列出区域内部包含的每一个点位。
SAW 流程均支持接收这两种格式作为输入。
如果使用 bin GEF 进行 lasso,运行分析如下:
saw reanalyze lasso \
    --gef=/path/to/input/GEF \
    --lasso-csv=/path/to/lasso/csv \
    --bin-size=1,20,50 \
    --output=/path/to/output/lasso

##  --lasso-geojson=/path/to/lasso/GeoJSON
--bin-size 参数可以接收一个列表,以便一次生成多个 bin size 的表达矩阵文件。
基于 bin GEF 的 lasso 输出如下:
lasso
├── <label1>
│       ├── SN.<label1>.label.gef  ##lasso GEF of bin1
│       └── segmentation
│              ├── SN.lasso.<bin_size_list[0]>.<label1>.gem.gz  ##GEM of lasso area of different bin sizes
│              ...
│              ├── SN.lasso.<bin_size_list[n]>.<label1>.gem.gz
│              └── SN.lasso.<label1>.mask.tif  ##mask image of lasso area
└── <label2>
       ├── ...
       └── ...
如果使用 cellbin GEF 进行 lasso,运行分析如下:
saw reanalyze lasso \
    --cellbin-gef=/path/to/input/cellbin/GEF \
    --lasso-csv=/path/to/lasso/csv \
    --output=/path/to/output/lasso

##  --lasso-geojson=/path/to/lasso/GeoJSON
基于 cellbin GEF 的 lasso 输出如下:
lasso
├── <label1>
│       ├── SN.<label1>.label.cellbin.gef  ##cellbin GEF of lasso area
│       └── SN.lasso.cellbin.<label1>.mask.tiff  ##cell segmentation of lasso area
└── <label2>
        └── ...
差异表达分析
SAW reanalyze 可以使用来自 StereoMap 的 diffexp GeoJSON 文件,基于聚类类群选择和套索区域进行差异表达分析。
从 StereoMap 4.3 开始,套索选择 (Lasso selection) 和差异表达分析记录的输出文件已标准化为 CSV 格式。虽然这两种格式(CSV 和 GeoJSON)都用于存储标签信息,但它们在数据表示方式上存在本质区别:
- CSV(基于点位 / Point-based): 每一行代表一个单一的坐标点 (x, y),明确列出了它的坐标位置以及被分配的标签 ID。它属于原始的、高分辨率的数据。
- GeoJSON(基于轮廓 / Contour-based): 定义了每个标签区域的边界轮廓(多边形 / polygons)。它侧重于描述区域的总体形状和范围,而不是逐一单独列出区域内部包含的每一个点位。
SAW 流程均支持接收这两种格式作为输入。
运行分析如下:
saw reanalyze diffExp \
    --count-data=/path/to/previous/SAW/count/result/folder/id \
    --diffexp-csv=/path/to/StereoMap/diffexp/csv \
    --output=/path/to/output/differential_expression

##  --diffexp-geojson=/path/to/StereoMap/diffexp/GeoJSON
--count-data 是相关联的 saw count 分析任务的输出目录,saw reanalyze 将自动搜索差异表达分析所需的数据文件。相关信息记录在 *.diffexp.csv / *.diffexp.geojson 中。
差异表达分析输出如下:
differential_expression
├── <SN>.<bin_size>_1.0.h5ad  ##H5ad containing analysis results
├── find_marker_genes.csv  ##original output CSV
└── <bin_size>_marker_features.csv  ##formatted CSV for visualization in StereoMap
或:
differential_expression
├── <SN>.cellbin_1.0.h5ad  ##H5ad for cellbin containing analysis results
├── find_marker_genes.csv  ##original output CSV
└── cellbin_marker_features.csv  ##formatted CSV for visualization in StereoMap
多样本场景
若要跨多个样本执行差异表达分析,需要基于 H5MU 文件进行。
saw reanalyze diffExp \
    --h5mu=/path/to/input/H5MU \
    --diffexp-csv=/path/to/diffexp/csv
输出的 H5MU 文件的 bin 大小与输入文件保持一致,基于 H5MU 的分析输出结果目录结构如下所示:
multi_sample_diffexp
├── <file_prefix>.binN_1.0.h5mu
├── <file_prefix>.binN_1.0_marker_features.csv
└── <file_prefix>.binN_1.0_find_marker_genes.csv
空间基因共表达分析
空间基因共表达分析(Spatial gene co-expression analysis)是一种通过整合基因表达数据和空间位置信息来构建基因间关联网络的计算方法。该方法旨在阐明基因间的相互作用模式,识别高度共变的基因集,并揭示基因功能和核心调控基因。
运行共表达分析:
saw reanalyze coExp \
    --gef=/path/to/input/bin/GEF \
    --bin-size=20 \
    --top-gene=5000 \
    --output=./gene_co-expression
基于 bin GEF 的空间基因共表达输出如下:
spatial_gene_co-expression
├── <SN>.<bin_size>.coexp.h5ad  ##h5ad containing analysis results
└── <SN>.<bin_size>.coexp.csv  ##analysis output CSV
当检查输出分析 CSV 文件时,有四列描述[基因-基因]共表达相关的信息:基因 ID、基因名称和每个基因的 Moran 指数等级。
$ head C04496D6_tissue_bin20/C04496D6.bin20.coexp.csv

module,geneid,real_gene_name,highly_variable_rank
Module0,ENSMUSG00000002107,Celf2,17.0
Module0,ENSMUSG00000028399,Ptprd,20.0
Module0,ENSMUSG00000063142,Kcnma1,27.0
Module0,ENSMUSG00000028519,Dab1,31.0
Module0,ENSMUSG00000054728,Phactr1,35.0
Module0,ENSMUSG00000059003,Grin2a,38.0
Module0,ENSMUSG00000049336,Tenm2,45.0
Module0,ENSMUSG00000020704,Asic2,48.0
Module0,ENSMUSG00000028033,Kcnq5,54.0
对于 SAW 中的空间基因共表达分析,建议将 bin size 设置为 20 或 50,或使用 cellbin。避免 bin size 设置过大,或是使用空间特征表达不明显(过低)的矩阵,其矩阵中可能无法检测到共表达基因,从而导致 CSV 文件中缺少缺少相关结果列。\ 目前,空间基因共表达分析主要适配空间转录组数据的分析。
基于cellbin GEF进行共表达分析:
saw reanalyze coExp \
    --cellbin-gef=/path/to/input/cellbin/GEF \
    --top-gene=5000 \
    --output=./gene_co-expression
基于 cellbin GEF 的空间基因共表达输出如下:
spatial_gene_co-expression
├── <SN>.cellbin.coexp.h5ad  ##h5ad containing analysis results
└── <SN>.cellbin.coexp.csv  ##analysis output CSV
蛋白组&转录组联合分析
saw multiomics 可以整合RNA和蛋白质数据,并通过 TotalVI 变分推断计算潜在空间。对潜在空间进行聚类分析,并进行 one-vs-all 差异表达分析,以找到标记基因和蛋白质。
您可以使用基因和蛋白 bin GEF进行联合分析,运行分析如下:
saw reanalyze multiomics \
    --gef=/path/to/input/gene/GEF,/path/to/input/protein/GEF \
    --protein-panel=/path/to/ProteinPanel.list \
    --bin-size=50 \
    --output=/path/to/output/joint_analysis
或使用基因和蛋白 cellbin GEF进行联合分析:
saw reanalyze multiomics \
    --cellbin-gef=/path/to/input/gene/cellbin/GEF,/path/to/input/protein/cellbin/GEF \
    --protein-panel=/path/to/ProteinPanel.list \
    --output=/path/to/output/joint_analysis
请确保找到样本在 saw count 使用过的蛋白列表。您也可以使用 --ref-libraries <CSV> 代替 --protein-panel <PANEL>。
联合分析输出如下:
joint_analysis
├── <SN>.<bin_size>.differential_expression.csv ##original outoput CSV containing differential expression results
└── <SN>.<bin_size>.h5mu ##mutimodal data containing clustering results
或:
joint_analysis
├── <SN>.cellbin.differential_expression.csv ##original outoput CSV containing differential expression results
└── <SN>.cellbin.h5mu ##mutimodal data containing clustering results
基于自定义MID范围过滤矩阵
StereoMap 中的交互式工具可以手动设置 feature 的 MID 范围。
saw reanalyze midFilter \
    --gef=/path/to/input/GEF \
    --mid-json=/path/to/FilterMID.json \
    --output=/path/to/output/mid_filtering
输出如下:
mid_filtering
└── <SN>.filter.gef ##common GEF filtered by MID range
或:
mid_filtering
└── <SN>.protein.filter.gef ##protein GEF filtered by MID range
自动去除蛋白背景信号
一种自动去除非特异性结合蛋白信号的方法。算法细节请查阅 Proteome background removal 。
saw reanalyze removeBackground \
    --gef=/path/to/output/input/protein/GEF \
    --bin-size=50 \
    --protein-panel=/path/to/ProteinPanel.list \
    --output=/path/to/output/removeBackground
请确保找到样本在 saw count 使用过的蛋白列表。您也可以使用 --ref-libraries <CSV> 代替 --protein-panel <PANEL>。
基于蛋白 bin GEF 的输出如下:
removeBackground
└── A03684D4.protein.tissue.rmbg.gem.gz ##protein expression matrix after backgrou