
拼片/TMA 样本分析
Overview概览
对于多组织样本贴片(同一张 Stereo-seq 芯片上的多个组织切片)或组织微阵列 (TMA) 样本,saw count / saw realign 支持识别空间上不连续的组织区域,并为它们分配唯一的标签 ID (label IDs)。
新增的 --split-tissue-into-labels 参数支持基于组织分割图的图形连通域进行自动识别、独立区域分离。该功能普遍适用于任何有效的组织分割图输入:无论组织分割是由流程内部的图像处理算法自动生成的,还是由用户进行手动处理的,它都能生效。
Demo 数据
本教程使用 Stereo-seq N 芯片的小鼠多组织贴片的演示数据。
Y40056J5K7 数据基本信息如下:
- 芯片尺寸:2cm * 3cm
- Bin1: 500 nm * 500 nm
- 5μm 厚度的组织切片
- Motic 显微镜拍摄得到的 ssDNA 染色图像
在数据集页面下载芯片 mask 文件、测序 FASTQ 数据、TIFF 图像或图像 tar.gz 文件,以及 reference 文件。为了更好地归纳和整理数据,建议为不同类型的文件创建对应的文件夹。
命令行
开启 Stereo-seq 演示数据的分析,该数据包含多组织区域:
cd /saw/runs/

/saw count \
    --id=Y40056J5K7_split_labels \
    --sn=Y40056J5K7 \
    --omics=transcriptomics \
    --kit-version='Stereo-seq N FFPE V1.1' \
    --sequencing-type=PE75_50+100 \
    --organism=Mouse \
    --tissue=Multiple \
    --no-bam \
    --split-tissue-into-labels \
    --image-tar=./Y40056J5K7_SC_20251203_102551_4.1.1.tar.gz \
    --chip-mask=./Y40056J5K7.barcodeToPos.h5 \
    --fastqs=./reads \
    --reference=./Mus_musculus_index_with_rRNA \
    --rRNA-remove
--split-tissue-into-labels 参数的使用与 Stereo-seq 试剂盒版本无关。无论文库制备采用何种化学试剂,它都可以应用于任何数据集。
输出文件
标签信息
启用此功能后,saw count / saw realign 会输出包含标签映射信息的 CSV 文件,允许在 StereoMap 中独立查看每个tissue core 或独立组织区域。输出 CSV 文件的 Bin 大小取决于 --custom-bin-size 的设置,以及是否执行了 cellbin 分析。
运行完成后,标签定义文件将输出在 ./outs/analysis/ 目录下:
./outs/analysis/
├── split_labels_adjusted_cell.csv
├── split_labels_bin1.csv.gz
├── split_labels_bin20.csv
├── split_labels_bin50.csv
├── split_labels_cell.csv
└── ...
split_labels_bin1.csv.gz 记录了 bin1 分辨率下每个 spot 的组织标签分配情况。由于数据量巨大,该文件通常非常大,因此以 GZIP 压缩格式输出,以优化存储效率。该文件无法导入 StereoMap 进行可视化。
若需可视化,请使用输出目录下的其他spot维度的标准标签映射 CSV 文件。
示例文件 split_labels_bin50.csv 的内容如下所示:
$ head ./split_labels_bin50.csv
X coordinate,Y coordinate,Group name,Label name,Bin size
9900,4850,Group01,Label01,50
9950,4700,Group01,Label01,50
9950,4750,Group01,Label01,50
9950,4800,Group01,Label01,50
9950,4850,Group01,Label01,50
10000,4750,Group01,Label01,50
10000,4800,Group01,Label01,50
10000,4850,Group01,Label01,50
10000,4900,Group01,Label01,50
可视化效果
下载流程生成的 split_labels_*.csv 文件并将它们导入 StereoMap,能够直观地检查预分配的标签信息,并验证每个组织切片或 TMA tissue core 的划分结果。
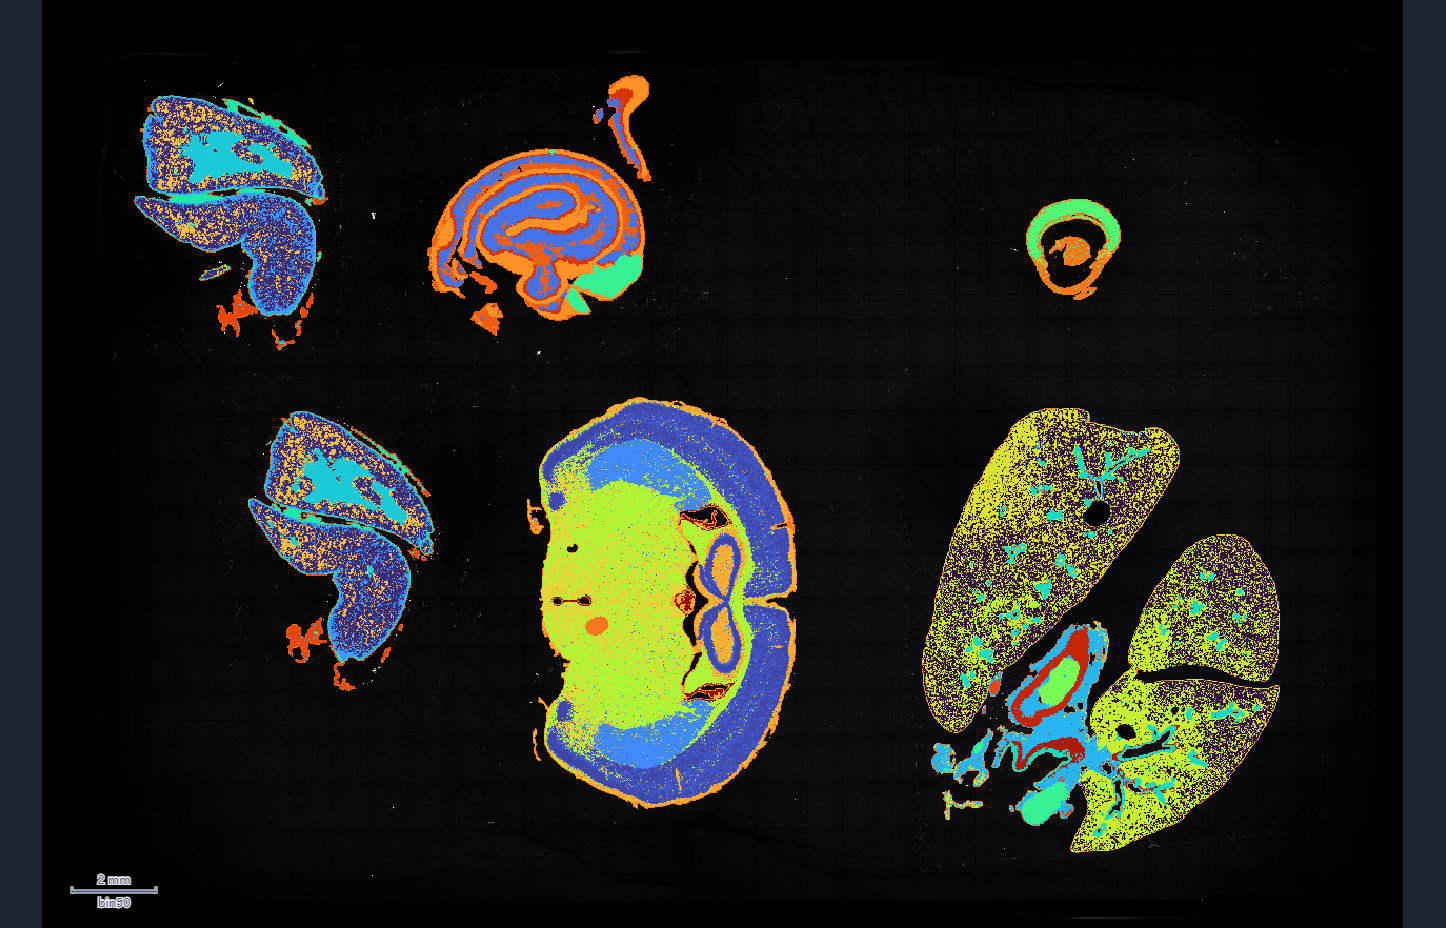
Leiden clustering of bin50 expression matrix
为 bin50 的 spot 分配标签:
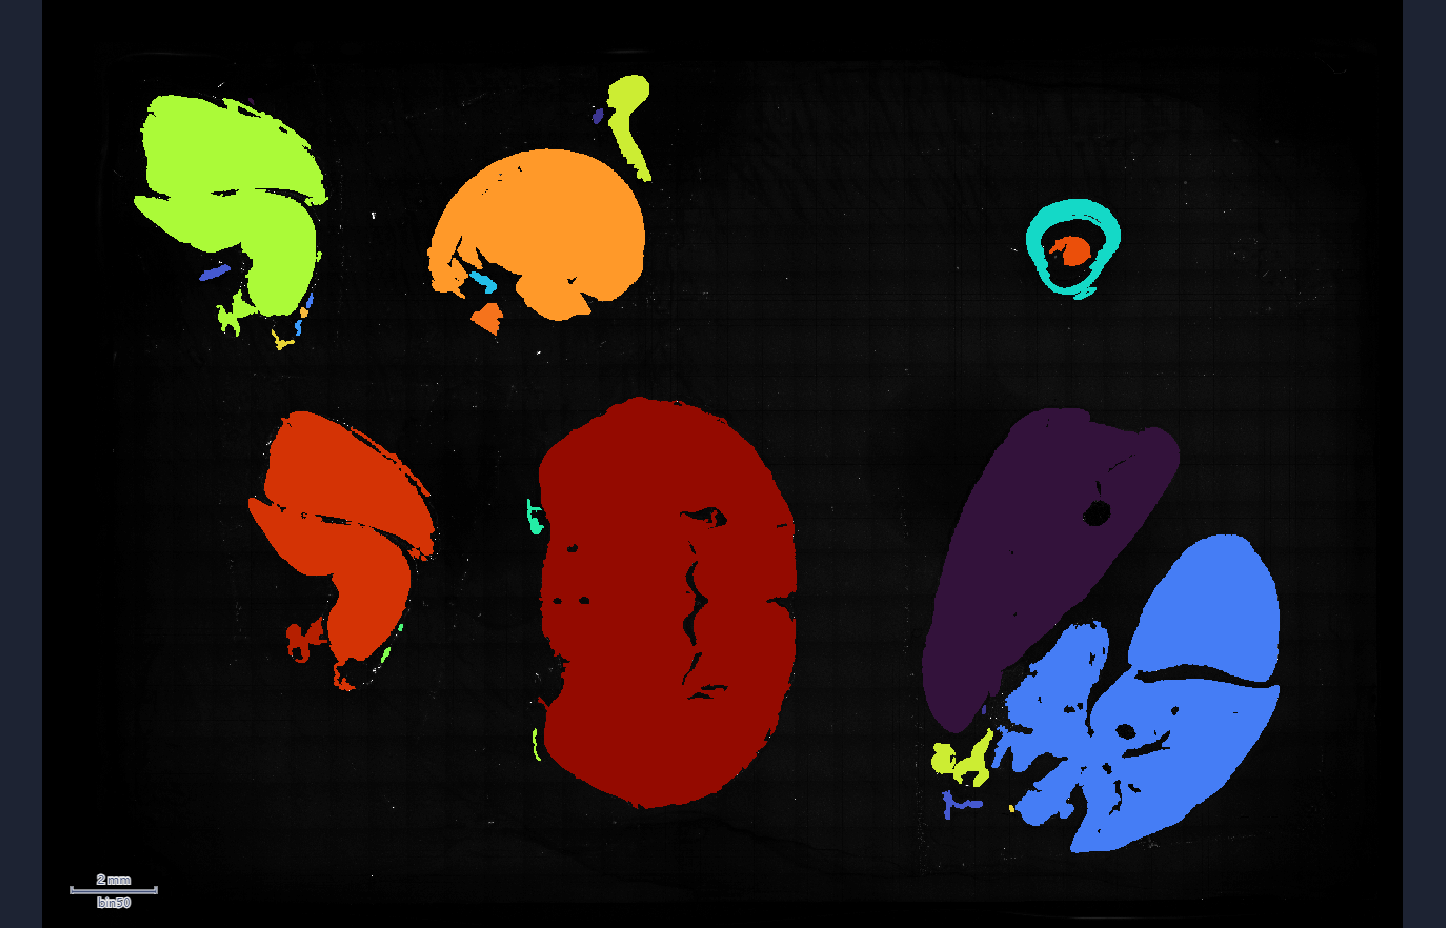
Split labels for bin50 spots
自动标签识别算法是基于图像连通域 (image connected components) 运行的,这意味着它会将任何空间上连续的区域识别为一个单一实体。因此,以下情况属于正常现象:
- 分散的组织碎片被分配了多个不同的标签 ID。
- 包含许多碎块的组织被分配了多个不同的标签 ID,尽管人眼会将其识别为单个生物样本。
手动修正
若出现上述情况,通常需要手动调整来处理碎片信息。建议使用 StereoMap 中的套索工具 (Lasso tool) 来微调局部区域,可以执行以下操作来校正标签分配:
- 合并 (Merge): 将多个破碎的标签合并为一个单独的组织标签。
- 拆分 (Split): 将融合在一起的区域分离为不同的标签。
导出矩阵
若需对各个独立的组织切片(section)或 TMA 核心点(cores)分别开展下游分析,可将每个 section 的表达矩阵拆分并导出为独立文件。建议在核对或微调标签注释后,直接在 StereoMap 中完成提取与导出。
推荐流程:
- 在 StereoMap 中打开多切片数据集,并导入对应的
split_labels_*.csv文件(或使用在 Modification 步骤中微调后的标签)。 - 在标签 / 子数据集管理面板中,核对并选择需要单独导出的目标组织标签或点阵区域。
- 导出矩阵,选择目标格式(
.gef或.h5ad)及所需分辨率(binN 或 Cellbin)。
更多详细操作请参考 StereoMap 用户手册/Analyze Multi-section Slide。